本系列课程记录学习Huggingface Transformers的过程,主要参考了官方教程和Natural Language Processing with Transformers: Building Language Applications with Hugging Face。
目录
本文介绍Transformer相关的模型,我们可以把它叫做一个家族体系。
Transformer架构
最早Transformer是用于机器翻译,也就是一个Seq2Seq框架的模型。它包括:
- Encoder
把一个输入文本序列编码成一个向量序列。
- Decoder
使用Encoder的隐状态来生成输出序列,一次一个,把上一次的输出作为当前的输入,也就是所谓的自回归解码。编码器-解码器的框架如下图所示:
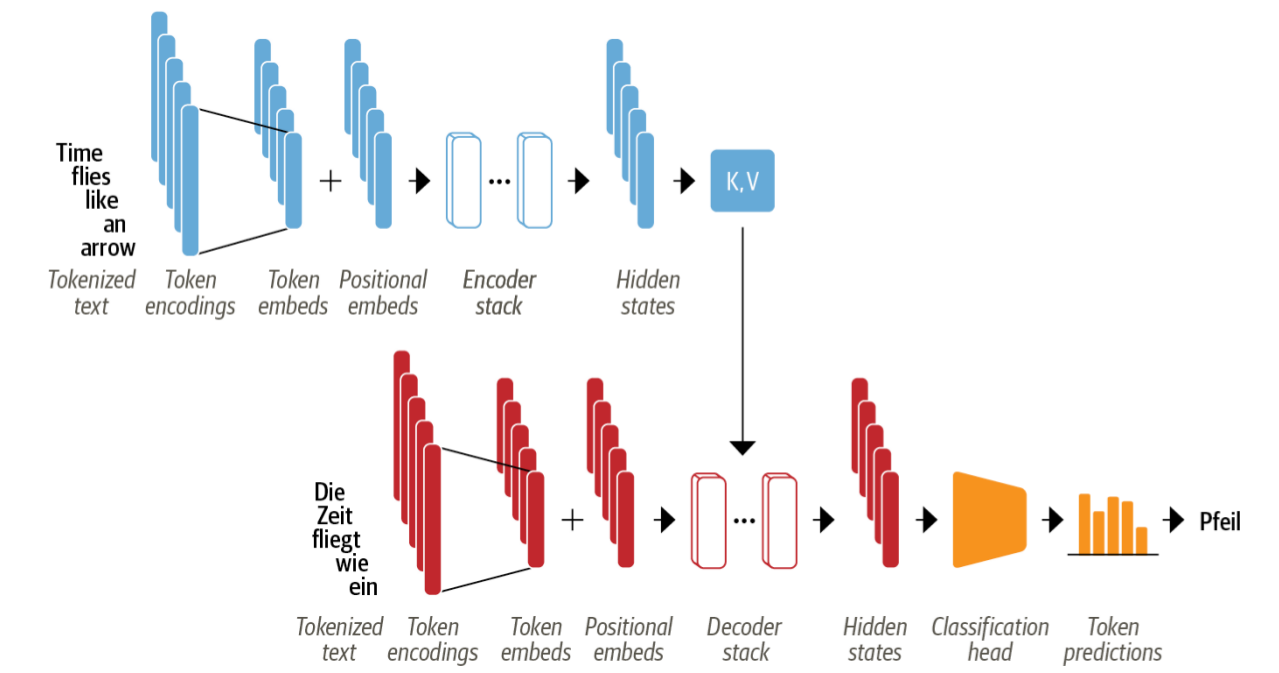
后面会详细介绍其中的部件,从图中我们可以看出这种架构有如下特点:
- 输入文本被切分成Token并且表示成Token Embedding。Transformer模型区分Token的位置差异,因此还需要加入Position Embedding。
- 编码器由很多的层组成,就像卷积网络的层堆叠成复杂的结构,解码器也是类似的由很多层组成。
- 编码器的输出会输入给解码器(最后时刻的输出直接输入到解码器,其它的输出通过注意力机制影响解码器),解码器每个时刻有一个输出,并且把输出作为下一个时刻的输入,直到遇到特殊的Token(比如EOS)或者超过预先设定的最大长度后停止解码。
最早的Transformer包含一个Encoder和一个Decoder,并且用于机器翻译这类Seq2Seq任务。但是后来单独的Encoder和Decoder也得到了很多应用。虽然具体的模型有很多种,但是总结起来不外乎如下三类:
- 只有Encoder
这类模型用来把输入序列转换成语义表达丰富的特征向量序列,从而很适合文本分类和命名实体识别等任务。这类模型的典型代表包括BERT及其变体。这种模型在编码某个Token的时候会同时参考前后上下文的信息,因此也叫双向注意力(bidirectional attention)模型。
- 只有Decoder
给定一段提示(Prompt)文本,比如”Thanks for lunch, I had a…“,然后让模型预测后面的文字,这是GPT这类自回归生成模型擅长的工作。
- Encoder-Decoder
同时包含Encoder-Decoder的模型适合机器翻译、自动文本摘要等序列到序列任务。而最早的Transformer就是用于机器翻译。后续的BART和T5模型也是同时包含Encoder和Decoder的预训练大模型。
了解了Transformer家族的大概情况之后,我们再详细的来看看Encoder的内部。
Encoder
Transformer的Encoder由很多encoder层堆叠而成。每一层encoder又是由如下子层组成:
- 多头自注意力(Multi-head self-attention)层
- 全连接层

每层输出的Embedding大小和输入一样。我们马上会看到,每层的主要功能就是更新Token的Embedding,使得它可以参考更多的上下文信息。举个例子,如果”apple”的上下文有”keynote”或者”phone”这些Token,那么它的Embedding会更加接近”company”而不是”fruit”。除了这两个子层,encoder层之间还会有skip连接和layer normalization。它们的目的是让网络训练更快。
自注意力(Self-Attention)
前面介绍过,注意力机制可以让网络给序列中的每一个元素赋予不同的权重或者说注意力。对于文本序列来说,元素指的是每个Token的Embedding,这是一个固定维度的稠密向量。对于标准的BERT模型来说,这个向量是768维的。而self的意思是,计算注意力的输入是这些向量序列本身。这主要是和Encoder-Decoder框架下的最早的注意力的区别,在Encoder-Decoder框架下,Decoder在解码的时候会“注意”到Encoder的隐状态序列,从而利用这些信息更好的解码。而对于BERT来说,它本身只有一个Encoder,所以它是在编码每一个Token时“注意”到自己所在的向量序列的每一个Token(当然也包括它自己的之前的隐状态)。
自注意力机制的核心思想是用整个Token序列的Embedding来计算当前Token的Embedding,方法是把整个Token序列的Embedding加权求和。形式化的语言来描述:假设整个Token的Embedding是$x_1,x_2,…$,通过自注意力机制计算后可以得到新的Token Embedding序列$x_1’, x_2’,….$,计算方法为:
$x_i’=\sum_{j=1}^{n}w_{ji}x_j$
加权系数$w_{ji}$叫做注意力权重(attention weight)并且满足$sum_{j=1}^{n}w_{ji}=1$。
用整个序列的Embedding来加权求和得到每一个Token的Embedding有什么好处呢?我们来看一个例子。考虑”flies”这个词,大家可能会马上想到那讨厌的虫子,但是如果有更多上下文,比如”time flies like an arrow”,我们马上会意识到flies应该是一个动词。因此,我们在计算flies的Embedding时,应该考虑整个上下文的Embedding,尤其是”time”和”arrow”这两个词应该贡献更大的权重。这种考虑上下文的Embedding叫做contextual embedding,它最早可以追溯到ELMo这样的模型。下图的例子显示了”flies”在不同的上下文的不同Embedding:

下面我来看看怎么计算自注意力的权重。
缩放的点积注意力
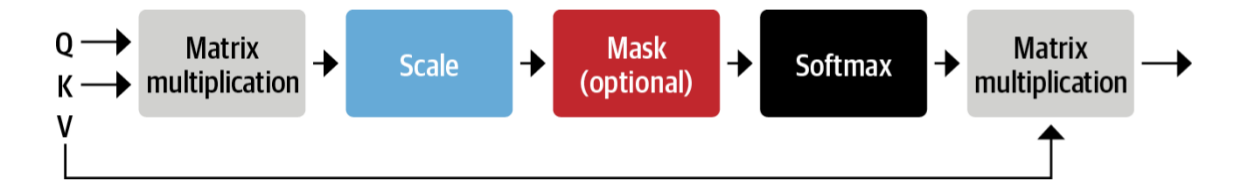
有很多方法来实现注意力的权重,最常用的就是Transformer原始论文中采用的缩放的点积运算方法。它包括如下四个步骤:
- 把每一个Token的Embedding都投影成Key,Query和Value三个向量
- 计算每对Token之间的相似度,也就是用Key向量点乘Query向量。可以用Key矩阵的转置乘以Query向量一次计算得到n*n的相似度矩阵,其中矩阵的第i行第j列表示Token i和Token j的相似度
- 对这个矩阵的每一行用softmax做归一化,从而得到Token的attention权重
- 用第i行的权重对所有Token的Value向量加权求和得到第i个Token的Embedding
我们可以使用BertViz这个库来可视化注意力的计算过程。这个库提供了许多函数来查看Transformer模型的attention,我们可以使用neuron_view模块来查看权重的计算,包括Query和Key等。因为需要交互的方式查看,我们最后需要调用show函数。
from transformers import AutoTokenizer
from bertviz.transformers_neuron_view import BertModel
from bertviz.neuron_view import show
model_ckpt = "bert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(model_ckpt)
model = BertModel.from_pretrained(model_ckpt)
text = "time flies like an arrow"
show(model, "bert", tokenizer, text, display_mode="light", layer=0, head=8)
结果如下图所示:
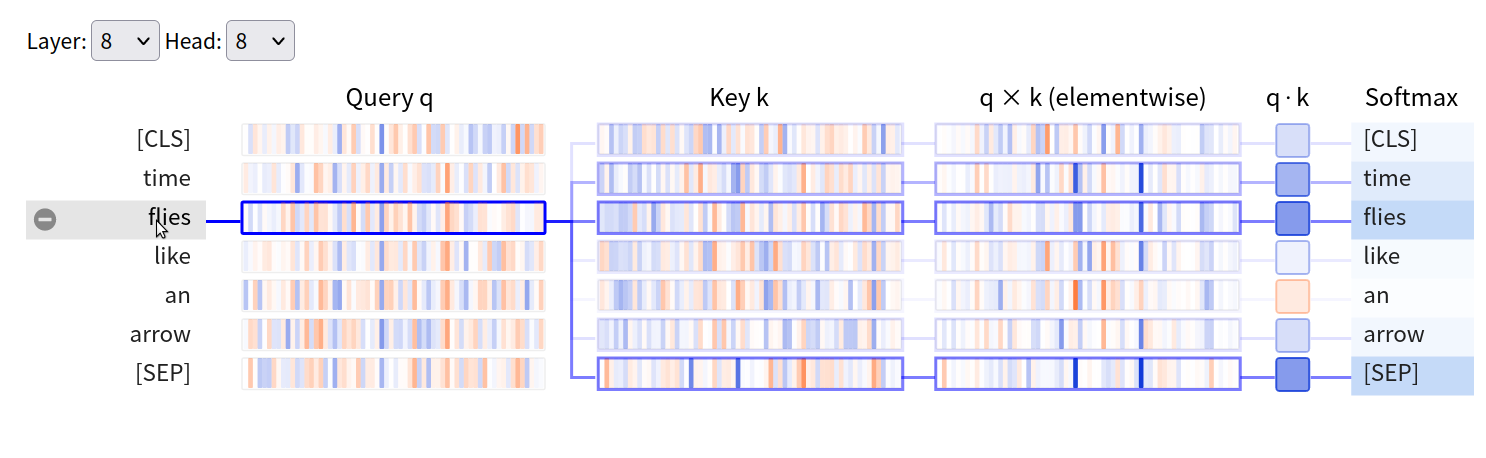
我们可以看到,Query和Key都用一个竖条来表示,颜色越深,代表值越大。我们选中”flies”后,可以看到它对于”times”的attention比较大。BERT模型有很多层,它有时候会学到类似人类语言学的特征,但有的时候并没有什么合理的解释。下面我们来看看Attention的详细过程,如下图所示: