本文是论文WeatherBench 2: A benchmark for the next generation of data-driven global weather models的翻译。
目录
Abstract
WeatherBench 2是由Rasp等人(2020年)提出的全球中程(1-14天)天气预报基准的更新版本,旨在加速数据驱动天气建模的进展。WeatherBench 2包括一个开源评估框架、公开可用的训练、地面真实数据和基准数据,以及一个持续更新的网站,提供最新的指标和最先进的模型:https://sites.research.google/weatherbench。本文描述了评估框架的设计原则,并展示了当前最先进的物理和数据驱动天气模型的结果。这些指标基于评估领先运营天气中心天气预报的成熟实践。我们定义了一组头条分数,以提供模型性能的概述。此外,我们还讨论了当前评估设置中的注意事项以及数据驱动天气预报未来的挑战。
1 Introduction
全球中程(1-14天)数值天气预报(NWP)是现代天气预报的关键组成部分(Bauer等人,2015)。它对经济和社会有着巨大影响,因为许多重要的天气事件发生在这个时间尺度上,例如热浪、热带和副热带气旋、干旱或导致洪涝的大量降水。除了提供有价值的预报外,全球NWP模型还有一系列额外的用途:它们为区域高分辨率模型提供边界条件;它们用于创建(再)分析;它们还作为研究人员更好地理解大气的工具。当前的NWP模型基于描述流体流动和热力学的控制方程的离散化(Kalnay,2002)。截至2023年,大多数全球模型的水平网格间距小于25公里。例如,欧洲中期天气预报中心(ECMWF)的集成预报系统(IFS)模型在其高分辨率(HRES)和自2023年升级以来的集合(ENS)配置中具有0.1◦的分辨率,约为9公里。然而,这仍然留下许多重要的物理过程未解决,例如云物理和辐射。这些过程对已解决尺度的影响必须在所谓的参数化中近似(Stensrud,2007)。NWP的另一个重要方面是估计大气当前状态,这是初始化模型预报所需的。这是通过数据同化算法完成的,该算法结合了模型预报和观测结果产生分析结果,对大气当前状态进行最佳猜测。过去几十年来,全球NWP在计算能力增加的推动下稳步提高,这反过来又使得分辨率更高、集合成员更多、观测和数据同化更好,以及对物理过程的更好表示成为可能(Magnusson和Källén,2013)。然而,尽管物理全球NWP取得了令人印象深刻的进展,但仍有大量改进空间。最近的研究估计,中纬度天气的内在可预测性极限约为15天,而当前的实际可预测性极限约为10天。剩下的5天潜在技能的约一半来自模型改进,另一半来自更好的初始条件(Zhang等人,2019;Selz等人,2022)。
近年来,在计算机视觉和自然语言处理等领域人工智能(AI)的兴起推动下(LeCun等人,2015),研究人员一直在探索使用现代机器学习算法进行天气预报的可能性。一些初步尝试构建数据驱动的中程NWP模型(Dueben和Bauer,2018;Scher,2018;Weyn等人,2019)导致了WeatherBench(Rasp等人,2020,以下简称WB1)的创建,这是一个全球中程天气预报的基准。WB1的目标是提供一个共同的、可重复的框架,用于评估全球数据驱动的预测,并将其与传统基线进行比较。基准对于衡量特定任务进展在ML社区中具有巨大影响。著名的例子包括ImageNet(Deng等人,2009),它帮助启动了计算机视觉领域的AI革命(Krizhevsky等人,2017),以及语言领域的GLUE基准(Wang等人,2018)。发布后,WB1被许多研究用于探索不同的机器学习方法。Weyn等人(2020)使用了一个立方球面投影,结合UNet架构,以2◦的分辨率迭代预测大气状态。Rasp和Thuerey(2021)使用了深度Resnet架构,在5.625◦的分辨率下直接预测了未来5天的领域。Clare等人(2021)类似地使用了Resnet,但增加了一个概率输出层。一个概率扩展版本的WeatherBench以及几个ML基线也被发布了(Garg等人,2022)。WB1指标的最新排行榜可以在https://github.com/pangeo-data/WeatherBench找到。这些研究,都使用了相对粗糙的分辨率,与当前物理NWP模型的技能相去甚远。
2022年初,数据驱动天气模型的改进在速度上显著提升。Keisler(2022)使用了图神经网络(GNN;Pfaff等人(2021)),以1◦和13个垂直层面的分辨率,每6小时迭代一次。在确定性上层验证指标上,该模型达到了与一些运营NWP模型相当的技能。Pathak等人(2022)使用了修改后的视觉变换器(Guibas等人,2022),称为FourCastNet,用于0.25◦的非常高分辨率和6小时的时间步长进行预测。最近还发表了使用球面傅里叶神经操作符的更新版本(Bonev等人,2023)。基于不同变体的视觉变换器Pangu-Weather(Bi等人,2023)以同样高的分辨率获得了优于HRES的确定性指标。不久之后,GraphCast(Lam等人,2023)在Keisler(2022)的基础上构建了一个GNN,将水平分辨率扩展到0.25◦。在许多确定性指标以及极端天气指标上,GraphCast也优于HRES。2023年,另一种视觉变换器变体FengWu(Chen等人,2023a)发表,具有长期预报领先时间的最先进确定性得分。类似地,FuXi模型(Chen等人,2023c)在15天内达到了与IFS集合均值相似的确定性得分。SwinRDM(Chen等人,2023b)结合了一个循环网络和扩散模型,提供了0.25◦分辨率的粒度预测。ClimaX(Nguyen等人,2023a)和Stormer(Nguyen等人,2023b)是在较低分辨率上获得竞争性技能的模型的例子。NeuralGCM(Kochkov等人,2023)代表了第一个混合ML-物理模型,获得了最先进的得分,包括一个集合版本。
鉴于该领域的迅速进展,需要一个更新的基准,以便轻松比较不同方法之间的差异。与WB1相比,WB2支持更高分辨率的数据和评估,并添加了额外的指标。本文将介绍WB2的设计原则,然后详细描述评估指标和数据集,以及头条分数的结果。我们还将讨论WB2的几个问题以及这个基准数据集的未来方向。
2. WeatherBench 2的设计决策
设计天气预报基准的一般挑战是天气是一个非常高维和多层面的问题(Dueben等,2022年)。每个使用案例都有略微不同的要求和质量度量标准。以欧洲中期天气预报中心(ECMWF)为例,这是世界领先的运营NWP中心之一。ECMWF跟踪大量指标来评估他们的模型性能。头条分数(https://www.ecmwf.int/en/forecasts/quality-our-forecasts)和评分卡(https://sites.ecmwf.int/ifs/scorecards/)作为简洁的总结,但只是冰山一角。除了定量分数之外,还会从内部专家和最终用户那里收集反馈,每个人都对预报系统的特定方面感兴趣。认识到特定分数的限制在评估基于ML的方法时更加重要,这些方法通常违反传统NWP中的标准假设。这一切都是为了说明没有单一的指标或一组指标将能够完全描述什么是“好”的预报。WB2不尝试这样做。与ECMWF类似,WB2定义了一组头条分数(在第5节中描述)和评估工具,旨在捕捉中程天气预报的关键方面,但并不意味着要详尽无遗。因此,WB2不应被视为一个传统的基准挑战,它有一个单一的排行榜,而应被视为一个比较不同方法在不同方面的工具。
在细节上,WB2的评估协议紧密遵循WMO(WMO)和ECMWF等运营气象中心使用的预报验证。WB2不试图重新发明这些标准验证协议,而是旨在使它们对对AI模型感兴趣的社区可访问。通过提供开源的地面真实数据和评估代码,以及提供一个单一的地方来比较不同的传统和AI方法。虽然WB2定义了要评估的目标,但它将剩余的建模设置保持开放(例如,使用哪些输入或模型分辨率)。从这个意义上说,WB2是一个整个预报系统的基准,即选择输入数据、训练设置和模型架构的组合,而不是专门关注模型。虽然这使得比较不同的模型架构变得更加困难,但我们认为设计预报系统组件的非模型部分同样重要,并且应该鼓励不同的方法来加快该领域的进展,只要避免过拟合。然而,重要的是要认识到不同的设计选择可能带来的优势和劣势。一个重要的选择是使用哪种输入数据集来开始(“初始化”)预报。目前,大多数模型使用再分析数据集,特别是ERA5,这在运营环境中不可用,并且相对于运营初始条件提供了潜在的优势(更多细节见第6.2节)。
WB2的另一个优先事项是强调概率预测的重要性。天气预报是一个固有的不确定性努力,因为由于混沌误差增长(Lorenz,1963年;Zhang等人,2007年),即使有完美的模型和近乎完美的初始条件,也会有一系列可能的结果。在运营NWP中,这个事实导致了在1990年代开发的集合预报系统(Palmer等人,1993年;Toth和Kalnay,1993年)。在一个集合中,运行一定数量的预报(通常为10-100个),并对初始条件和有时模型物理进行扰动,提供未来天气的不同潜在实现。集合预报的最重要优势之一是它们可以为决策提供可靠的信息。例如,它们可以用来估计单一的确定性预报可能忽视的极端事件的概率。热带气旋路径预测(通常显示为尾流)是这一点的一个典型例子。上面讨论的数据驱动模型,除了Pangu-Weather论文中的扰动集成实验外,所有都只提供确定性预报。与动力学预报系统的发展类似,数据驱动的预报将需要变得概率化,以为用户提供最可操作的信息。这可能是在确定性模型的基础上进行后处理的一步,例如通过集合装饰或滞后预报。然而,NWP集合的成功暗示了从基础开始设计概率预报系统的优势,特别是用于捕捉时空相关性。因此,WB2将从一开始就包括运营概率验证指标和基线。在数据驱动建模中,有几种方法可以创建概率预报,从直接预测参数化的边际分布(Andrychowicz等人,2023年)到生成式展开。如何评估这些预报的一些方面在第6.3节中进行了讨论。
最后,WB2将提供一个动态的、开源的框架,可以随着ML-weather社区的需求不断发展。所有用于评估的数据和代码都是公开可用的,可以在将来由我们或社区贡献者扩展,以适应更详细的评估需求。
3. 数据、基线和数据驱动模型
大多数下面列出的数据集都以 Zarr 格式在 Google Cloud Storage 上提供。有关这些数据集的最新详细信息,请访问 https://weatherbench2.readthedocs.io/en/latest/data-guide.html。表格1提供了每个数据集/模型的关键信息摘要,包括训练资源。
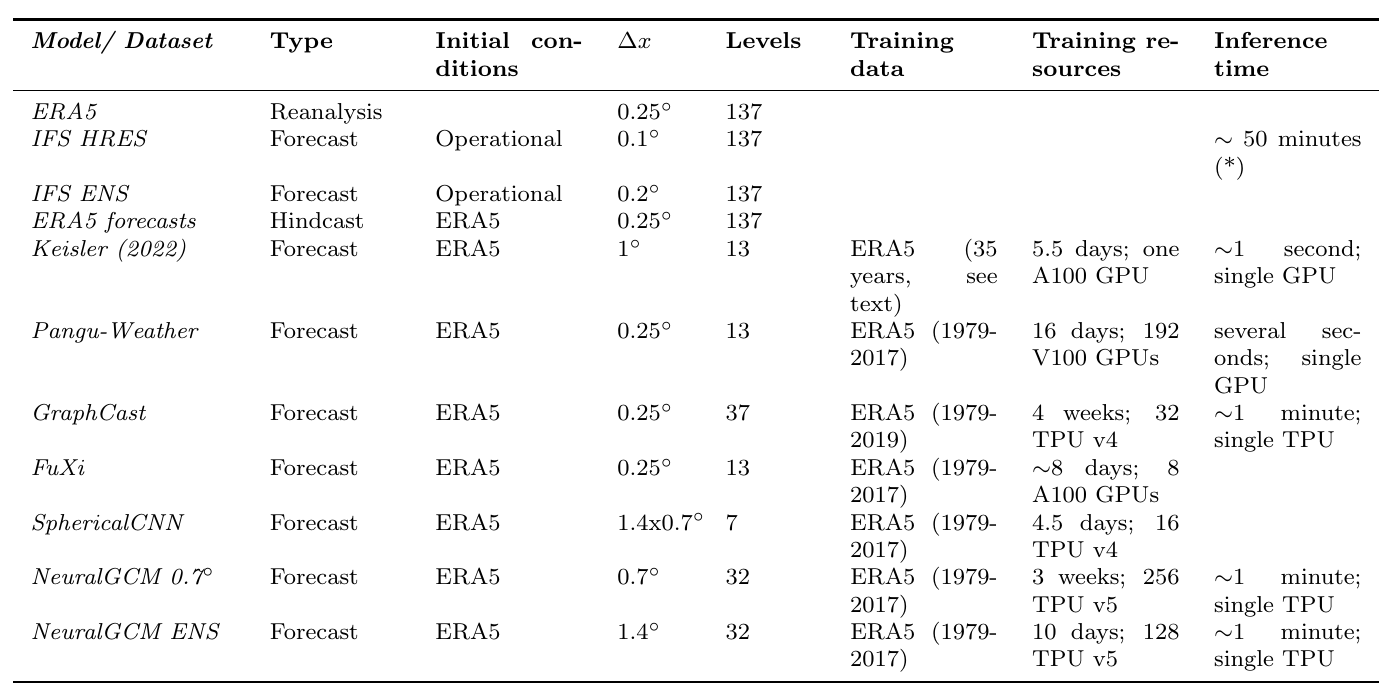 表1:数据集和模型表格;∆x指的是水平分辨率,“levels”指的是输入和输出中使用的垂直模型层级数量。(*) 请参考文本中关于IFS推理时间的详细信息。GPU = 图形处理单元。TPU = 张量处理单元。
3.1 ERA5数据集
ERA5数据集(Hersbach等,2020)被用作WB2的地面真实数据集,并且作为上述许多数据驱动方法的训练数据集。ERA5是一个基于2016年(周期42r1)ECWMF HRES模型的0.25◦(约30公里)版本和ECMWF的4D-Var数据同化的再分析数据集,它使用广泛的直接和遥感观测。ERA5使用从21-09和09-21 UTC的12小时同化窗口,在这期间,从前一次同化窗口初始化的“先前”预报与观测结合产生一个分析,对这个窗口期间地球系统状态的“最佳猜测”。ERA5数据可在Copernicus气候数据存储(https://cds.climate.copernicus.eu/)上以小时分辨率从1940年至今提供。ERA5数据集的子集以云优化的Zarr格式提供在云中。
请注意,使用ERA5进行评估和训练有一些注意事项。首先,尽管试图接近观测值,ERA5是一个模型模拟,对于某些变量而言,其接近真实的程度可能不同。特别是对于降水,ERA5有时与雨量计测量存在较大差异(Lavers等,2022年)。我们仍然在此基于ERA5包括降水评估,但在解释这些结果时建议谨慎(有关更多细节,请参阅第6.1节中的讨论)。其次,与运营预报相比,ERA5使用了较长的同化窗口(见下文)。这有助于更好地约束大气状态的猜测,但会延迟在实时环境中的预报初始化。例如,在00 UTC,ERA5的同化窗口“向前”延伸9小时。在运营环境中,数据同化窗口仅从预报初始化时间开始延伸3小时。可以使用06/18UTC初始化来使竞争环境更加平衡一些。这个问题在(Lam等,2023年,图10的补充资料中)已经广泛讨论过,他们发现从ERA5初始化的预报在00/12 UTC确实比从06/18UTC初始化的预报效果更好,因为ERA5分析也只有3小时的前瞻性。GraphCast的RMSE差异达到了5%。然而,与00/12UTC分析相比,06/18UTC运营分析也使用较少的DA周期。对于WB2,我们选择评估从00/12UTC开始初始化的预报。这样做的主要原因是一些关键的基线(IFS ENS和ERA5预报)只能在00/12 UTC初始化时使用,并且到目前为止,这一直是大多数其他基于ML的评估的标准,这样可以直接在这里包含其中一些。
ERA5预报
为了研究目的,ECMWF运行了一组从ERA5状态在00/12UTC初始化的10天预测,使用与创建ERA5相同的IFS模型版本。这些预报可以在MARS存档中找到(MARS参数:class=ea,stream=oper,expver=11,type=fc)。在这里,我们下载了计算2020年头条分数所需的变量(除了总降水量不可用)。请注意,直到5天的预测时间可以以6小时间隔获取数据,而5到10天的预测时间则以12小时间隔提供数据。
ERA5预报为从ERA5初始化并对其进行评估的AI模型提供了一个同类基准。它们受益于与运营初始条件相比较长的同化窗口,并且以0.25◦分辨率运行,与许多现代AI方法类似。由于分辨率较低且模型相对于2020年的运营IFS HRES较老,人们预计运营模型本身会更加熟练。
3.2 气候学
气候学用于计算某些技能得分,特别是异常相关系数(ACC)和概率空间中的稳定公平误差(SEEPS),并作为基线预报。在这里,我们遵循Jung和Leutbecher(2008)的做法,通过将1990年至2019年(含)的ERA5数据在每个网格点上进行平均,计算气候学c作为年份(doy)和一天中的时间(tod)的函数。每个doy-tod组合周围使用61天的滑动窗口,并使得权重从中心线性衰减至零。这样做可以消除样本噪声,并使气候学在时间上更加平滑,但会降低季节振幅。
通过将1990年至2019年的每一年视为一个集合成员,创建气候学的概率版本,这次不进行平滑处理。
请注意,30年的气候学将包含一些气候漂移,特别是温度方面。在这里,我们没有采取任何措施来纠正这种情况。
3.3 IFS HRES
我们的主要基线来自于使用ECMWF的IFS模型创建的运营预报,根据标准验证指标,这些预报通常被认为是最佳的全球中期天气预报。自2016年以来,IFS在其HRES配置下以0.1◦(大约9公里)的水平分辨率运行。运营模型定期更新,大约每年一到两次,这意味着在评估期间确切的模型配置可能会发生变化。通常情况下,更新与大多数评估指标有轻微的改善,尽管不是全部。但是,IFS的变化通常是渐进的。可以在https://www.ecmwf.int/en/publications/ifs-documentation找到全面的模型描述。模型升级计划可以在https://confluence.ecmwf.int/display/FCST/Changes+to+the+forecasting+system找到。初始条件每6小时创建一次,使用一个集合4D-Var系统,利用上一个同化周期的预报信息以及+/- 3小时窗口内的观测数据。考虑到执行数据同化和正向模拟所需的时间后,从初始化时刻到预报产生的时间延迟为5.75到7小时(https://confluence.ecmwf.int/display/DAC/Dissemination+schedule)。在00和12 UTC开始的预报可延续10天。06和18 UTC初始化的预报可延续3.75天。
在用于运营集合的设置中进行15天的TCO1279 (∼ 9km)模拟,使用新的高分辨率设置需要大约52分钟(包括I/O),不包括I/O则需要46分钟,使用64 128核心(AMD EPYC Rome)节点。
IFS HRES初始条件
为了评估IFS预报,我们使用运营分析作为地面真实情况,而不是使用ERA5。这是因为将IFS预报与ERA5进行比较会导致在时间步t = 0时出现非零误差,因此会使IFS与针对ERA5进行训练和评估的数据驱动模型相比处于不公平的劣势。这种差异在早期前导时间中最为明显,在较长的前导时间中变得较小。参见图S2进行比较。请注意,对于一些变量,如2m温度差异即使在较长的前导时间中仍然存在。这可能是由于HRES分析与ERA5之间存在偏差造成的。
在这里,我们像Lam等人(2023年)一样使用初始条件,即t=0时的IFS HRES预报作为我们的“分析”。请注意,这个数据集与ECMWF档案中的官方分析产品略有不同。这是因为官方分析产品采取了额外的地表数据同化步骤。对于ECMWF的内部评估,使用官方分析产品。然而,由于这种差异导致的评估分数的定性差异应该很小,除了初始化后的第一个时间步之外,主要限于地表温度。对于非常短的前导时间,结果不应该过度解释。请注意,对于降水累积量,我们对所有模型使用ERA5作为降水地面真实情况。
3.4 IFS ENS
ECMWF还运行IFS的集合版本(ENS),直到2023年升级之前的分辨率为0.2°(包括这里使用的2020年评估期),现在为0.1°分辨率。集合由一个控制运行和50个扰动成员组成。扰动成员的初始条件是通过运行数据同化集合(EDA)来创建的,其中观测误差、模型误差和边界条件误差由扰动表示。然后,将每个EDA分析与均值的差异用作对HRES初始条件的扰动。此外,为了更准确地表示预报的不确定性,在初始条件中添加了奇异向量扰动。预报期间的模型不确定性由随机扰动参数化趋势(SPPT)表示,其中向模型物理趋势添加了空间和时间相关的扰动。集合预报在00和12 UTC初始化,并运行到15天。
IFS ENS均值
我们还将IFS ENS均值作为基线进行考虑,这是通过简单地对50个成员进行平均来计算的。集合平均值并不代表一个现实的预报,但在确定性指标上通常表现良好。
3.5 Keisler (2022) Graph Neural Network
Keisler (2022) 使用了图神经网络架构(Pfaff等,2021),其中包括一个编码器,将原始的1°纬度-经度网格映射到一个二十面体(icosahedron)网格,在该网格上进行多轮消息传递计算,然后解码回到纬度-经度空间。该模型以 t = 0 和 t = -6h 时刻的大气状态作为输入,并预测 t = 6h 时刻的状态。为了预测更长时间的时段,模型的输出被自回归地作为输入反馈。该状态包含13个压力水平上的6个三维变量。使用 ERA5 数据进行训练,其中1991年、2004年和2017年用于验证,2012年、2016年和2020年用于测试,其余年份从1979年到2020年用于训练。在训练过程中,模型被训练以最小化长达12个时间步长(3天)的累积误差。
3.6 Pangu-Weather
Pangu-Weather(Bi等,2023)是一种基于Transformer架构的数据驱动天气模型。它基于当前状态预测 t = t + ∆t 时刻的大气状态。该状态由5个高空变量和4个地表变量描述,采用0.25°水平网格(与ERA5相同),高空变量有13个垂直层级。该模型使用了1979年至2017年(含)的ERA5数据进行训练,使用2019年进行验证,使用2018年、2020年和2021年进行测试。这里我们评估了2020年的预测结果。针对不同的预测时间步长 ∆t = {1h, 3h, 6h, 24h},训练了四种不同版本的模型。为了为任意提前时间创建预测,从四个不同提前时间的模型预测中自回归地链接起来,使用最少的步骤。例如,要创建一个31小时的预测,先是24小时的预测,然后是6小时的,再是1小时的。这里使用的数据的最大提前时间为7天。Pangu-Weather的推理代码可在 https://github.com/198808xc/Pangu-Weather 找到。
Pangu-Weather(运行版本)
评分卡中还包含了一个以操作性IFS HRES初始条件为基础初始化的Pangu-Weather版本(参见上文)。
3.7 GraphCast
GraphCast(Lam等人,2023年)与Keisler(2022年)在结构上相似,但使用更高分辨率的输入,包括6个上层变量,在0.25◦水平网格上有37个垂直层,此外还有5个表面变量。此外,处理器采用多网格结构,即不同分辨率网格的嵌套结构。该模型还通过自回归训练,达到12个时间步长(3天)的时间范围。在这里,我们评估了一个在ERA5数据(1979年至2019年)上进行训练的GraphCast版本。详情请参阅Lam等人(2023年)的Suppl. 5.1。GraphCast的代码可在https://github.com/deepmind/graphcast找到。
GraphCast(运行版本)
评分卡中还包含了一个根据操作性IFS HRES初始条件进行微调和初始化的GraphCast版本(参见上文)。有关更多详细信息,请参阅https://github.com/deepmind/graphcast。
3.8 FuXi
FuXi(Chen等人,2023年)是一个基于Transformer架构的自回归级联机器学习天气预测系统,针对短期(0-5天)、中期(5-10天)和长期(10-15天)预测训练了特定模型。该模型在0.25◦水平分辨率和13个垂直层上使用ERA5数据进行训练。
3.9 SphericalCNN
球面卷积神经网络(Esteves等人,2023年)将卷积神经网络(CNNs)推广到球面上的函数,通过使用球面卷积作为主要的线性操作。该天气模型以1.4◦经向和0.7◦纬向的分辨率生成输出,具有7个垂直层。代码可以在https://github.com/google-research/spherical-cnn找到。
3.10 NeuralGCM
神经广义环流模型(NeuralGCM)(Kochkov等人,2023年)将微分动力核心与可学习的物理相结合。NeuralGCM已经在高分辨率的确定性版本(0.7°)和较低分辨率的集合版本(1.4°)进行了训练。这两个模型版本都使用32个垂直层。
4. 评估协议和指标
WB2的评估协议紧密遵循世界气象组织(WMO)和ECMWF等操作性气象中心使用的预报验证方法。表2提供了使用的符号列表。
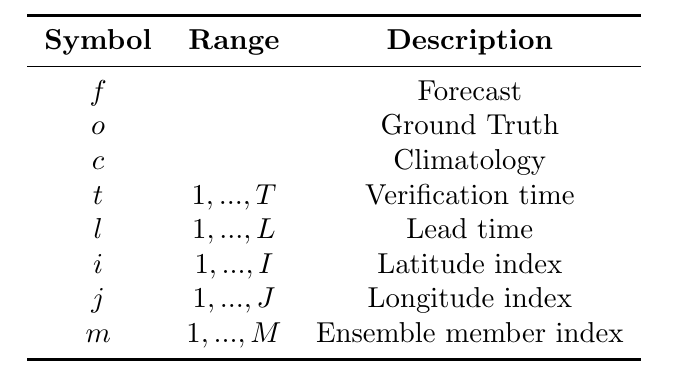 表2 评估指标中使用的符号。
4.1 评估时间段和初始化时间
在最初的版本中,WB2使用了2020年。选择2020年的原因有两点:a)它在最新性和如果建模组希望进行独立测试还剩下几年的情况之间提供了一个折中;b)因为许多AI基线模型的数据是可用的。对于大多数下面定义的指标来说,一年的样本量也足够可靠。然而,对于聚焦极端事件的指标,例如飓风或热浪,需要更大的样本量。随着WB2的更新,评估可以更改为更新的或更长的时间段。
值得讨论的是,许多AI模型仅使用到2018年的数据进行训练。对GraphCast模型的分析显示,使用更新的数据训练是有利的(Lam等人,2023年)。此外,IFS模型不断改进,表明更近期的预报更好。然而,由于每年都存在自然波动,因此比较绝对值是困难的。在图S1中,我们展示了2018年的得分(也可在网站上找到)。2018年和2020年之间得分的相对差异很小,这意味着至少对于这里显示的指标来说,结果是稳健的。
评估是在2020年的所有00和12 UTC初始化时间上进行的,即从2020年1月1日00UTC到12月31日12UTC。这意味着一些预报将延伸到2021年。我们将此与仅评估在2020年有效的预报导致的差异进行了比较,但得分的差异微乎其微。评估时间步骤可以自由选择。我们使用6小时作为最高分辨率。
4.2 评估分辨率和区域
在计算指标之前,所有预报和实况数据都被重新网格到1.5°的分辨率。重新网格工具可以在WB2的GitHub页面上找到。1.5°也被用作WMO和ECMWF评估的标准分辨率。重新网格到共同的较低分辨率可以使所有模型在评估时都不会因分辨率较低而受到惩罚。绝对指标值在不同分辨率之间可能会有显著差异,但不同模型之间的相对差异在不同评估分辨率下是一致的(请参阅图S9查看不同分辨率下IFS HRES得分的比较,并查看WeatherBench 2网站查看所有以不同分辨率评估的模型)。然而,这不应该让人误以为高分辨率模型不会更准确,因为相关的小尺度细节是可以被解决的。
本文中展示的所有结果都是在全球网格点上计算的。此外,网站https://sites.research.google/weatherbench上展示了在许多其他区域计算的得分。
地下(Below-ground)网格点
对于一些压力层次(例如850hPa),高海拔地区的网格点将“在”地下;即,地面压力实际上小于该压力层次。ERA5和IFS输出仍然会在这些位置提供插值的数值,尽管它们并不对应于真实的物理变量。在这里,我们排除了地下网格点的计算。为此,我们使用与第3.2节中描述的相同的doy-tod相关方法,计算每个压力层次的地上网格点的气候学分数(由地势确定>地表地势)。然后,我们在计算空间平均值时使用此分数作为额外的权重。我们选择基于气候学值实现地下蒙版,而不是基于实际的预报或实况值,因为当ML模型明确针对预报或实况值有偏置的得分进行训练时,可能会导致偏向性预测。
4.3 确定性指标
所有指标都是通过对网格点进行面积加权计算的。这是因为在等距纬度经度网格上,极地的网格单元面积要远远小于赤道处的网格单元面积。将所有单元格权重一样会导致对极地地区的过度偏向。纬度权重w(i)的计算如下:
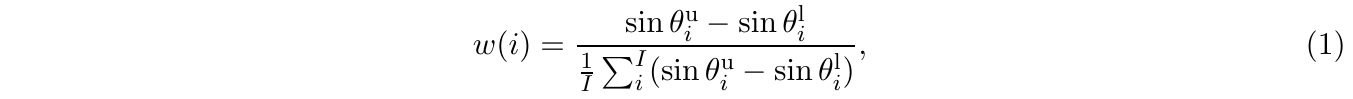
其中$\theta_i^u$和$\theta_i^l$分别表示具有纬度索引i的网格单元的上下纬度界限。所有垂直(压力)层次都分别处理。为了方便阅读,在下面的方程中没有包括层次索引。
4.3.1 均方根误差(RMSE)
均方根误差(RMSE)针对每个变量和层次定义如下:
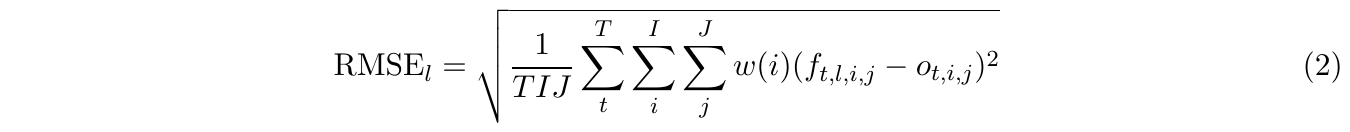
请注意,这与WMO和ECMWF使用的RMSE定义一致。在WB1中,均值是在平方根外计算的。我们比较了这两个版本,并发现差异很小(平均绝对差异小于2%)。
风向矢量(WV)的均方根误差计算如下:
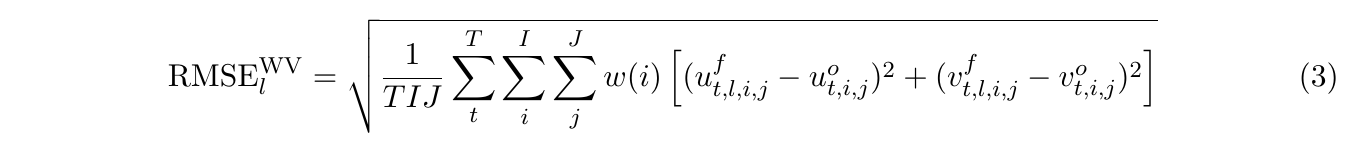
其中$u^f, u^o, v^f, v^o$分别是预报和观测中风的u和v分量。
4.3.2 异常相关系数(ACC)
ACC是根据与气候学的异常相关系数计算的皮尔逊相关系数:
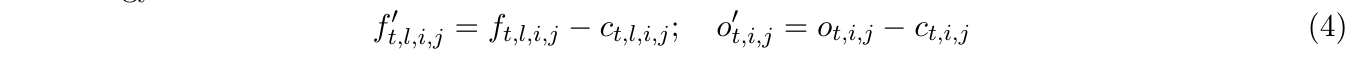
其中$c_{t,l,i,j}$和$c_{t,i,j}$分别表示与适当的tod - doy组合对应的气候学。然后,ACC定义为
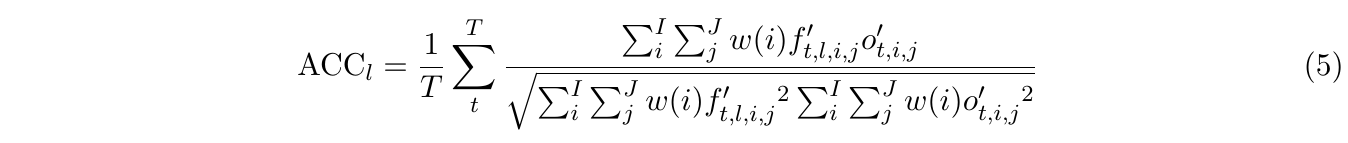
ACC值的范围从1表示完美相关,到-1表示完美反相关。气候学预测的ACC值为零。ECMWF指出,“当“ACC值低于0.6时,认为对预测目的失去了大尺度特征的定位价值”。
4.3.3 偏差
平均误差,或简称偏差,被计算为每个位置i,j如下:
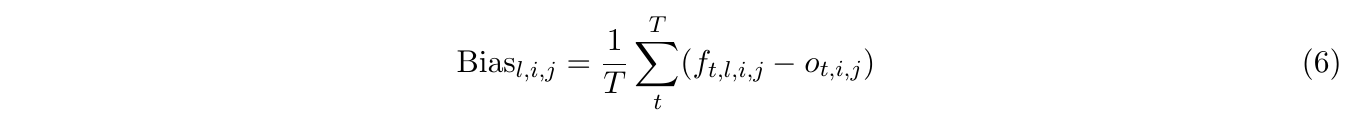
此外,我们计算全球平均的均方根偏差(RMSB)如下:
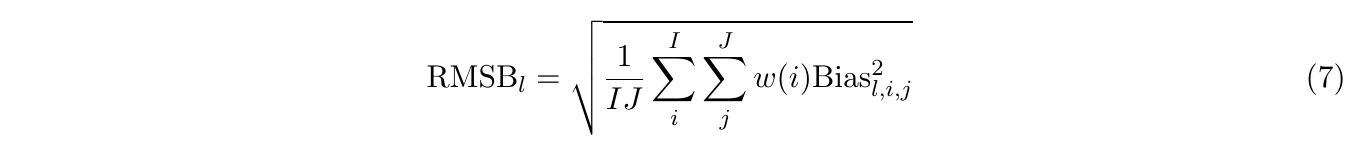
4.3.4 稳健的概率空间中的公平误差 - SEEPS
传统的确定性评分,如RMSE和ACC,不适合评估降水预报。这是因为降水具有非常偏斜的分布和高度的时空间间歇性或不可预测性。在这种情况下,传统的评分严重偏向于不切实际的平滑预报。这对所有变量都是如此,但对偏斜变量尤其明显。因此,ECMWF和WMO决定在其常规确定性降水评估中使用SEEPS分数(Rodwell等人,2010年)。SEEPS分数基于对“干燥”、“轻度”和“重度”降水进行三类分类。该评分设计旨在避免“避险”(即平滑预报)并对参数选择稳定。有关分数背后的详细信息,请参阅Rodwell等人(2010年)的论文。这里,我们描述了如何计算该分数以及计算与原始论文略有不同之处。
我们使用0.25毫米/天(6小时累积为0.1毫米/天;在网站上显示)的干燥阈值。剩余的降水值被分类为轻度和重度,而在气候学上,与重度降水日相比,轻度降水日数量是两倍。我们通过计算day-of-year的非干燥天的2/3分位数来计算这个值,这与计算平滑气候学的相同过程在第3.2节中描述。这与大多数其他SEEPS计算不同,后者使用月度气候学。但由于每日气候学是平滑的,这并不太影响结果。然后将预报/观测对分类为三类,并为每个预报领先时间创建一个3x3的列联表。然后,根据每个地理位置的干燥日p1的年均气候发生率基于得分矩阵S对列联表进行乘法运算:
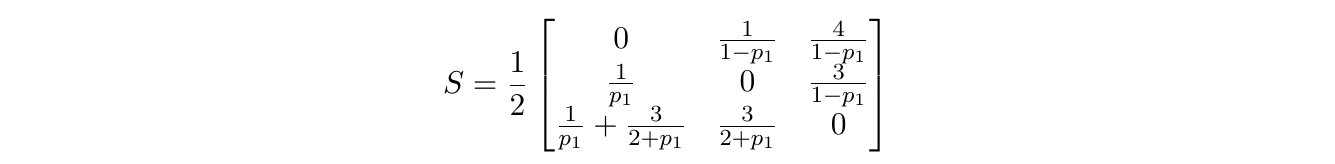
其中列代表观察到的概率,行代表预测概率。
非常湿润和非常干燥的地区被排除在外。这里我们使用0.1 < p1 < 0.85,这是Rodwell等人(2010年)建议的。最后,在所有位置上进行面积加权平均。
在图中,我们展示了(1-SEEPS),这是更常见的面向正面的技能得分版本。
4.4 Probabilistic metrics
4.4.1 Continuous ranked probability score (CRPS)
| 给定标量的真实值Y,以及独立同分布的预测X、X’,CRPS被定义为E|X −Y|− 1/2 E|X − X’ |(Gneiting和Raftery,2007)。技能项E | X − Y | 惩罚不良的预测,而− 12 E | X − X ′ | 鼓励散开。当X从与Y相同的分布中抽取时,CRPS最小化。要了解这一点,请考虑两个独立同分布的真实值样本,Y,Y ′,然后从CRPS中减去 2 1 E | Y − Y ′ | 到达发散关系。 |
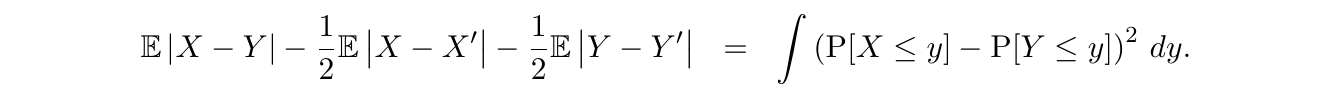
因此,标量CRPS等于它们累积分布函数的L2差的平方,其中差值的常数独立于预测。在确定性预测的情况下,CRPS减少为MAE。
WeatherBench考虑多维预测,$f_{t,l}$,条件是初始真实值$o_{t−l}$。对于这些情况,CRPS被定义为在时间/纬度/经度组件上进行平均。我们还利用M ≥ 2个预测\(\{f^{(1)}, ..., f^{(M)} \}\)。
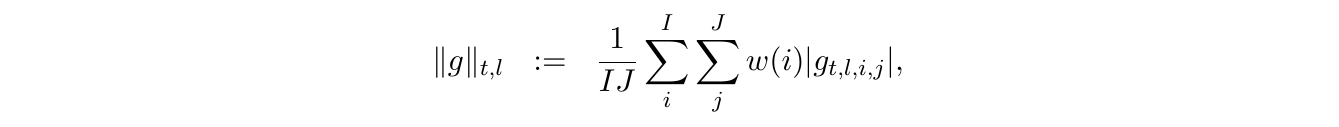
我们定义:
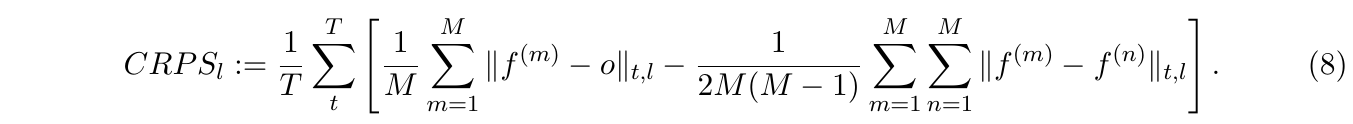
设定这是无偏(条件)CRPS的时间平均值(Zamo和Naveau,2018)。对于足够大的T,这是CRPS的条件估计的准确估计。因此,任何具有与$o_{t−l}$条件下时间t的真实值相同组件分布的预测$f_{t,l}$都将使其最小化。
第二项(8)可以使用排序而不是双重求和以O(MlogM)时间和O(M)内存高效计算。也支持确定性预测的CRPS(其中M = 1),在这种情况下,CRPS减少为(加权)平均绝对误差。
4.4.2 Spread-skill ratio
spread-skill R 定义为集合散度与集合平均的RMSE之间的比值,
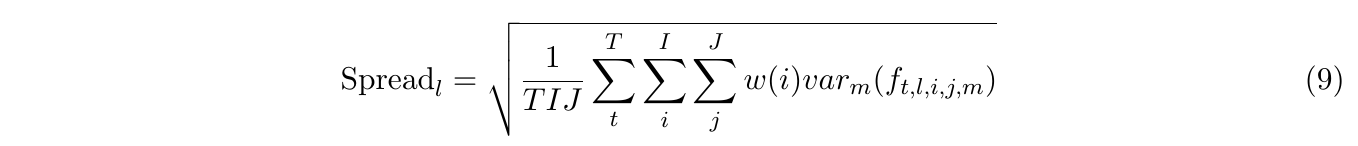
其中 $\text{var}_m$ 是集合维度中的方差。
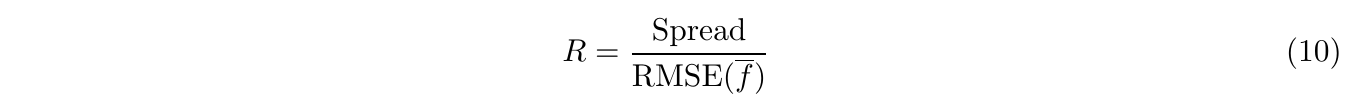
良好校准的集合预测应具有散度技能比例为1(Fortin等人,2014)。较小的值表示欠散的预测,而较大的值表示过散的预测。请注意,散度技能比例只是用于校准的一阶测试。要进一步诊断集合校准,秩直方图是一个合适的选择(Wilks,2006,第7.7.2章)。我们计划很快将其包含在WB2中。
4.4.3 能量谱
沿着恒定纬度线的经向能量谱被计算为波数(无单位)、频率($m^{-1}$)和波长(m)的函数。
对于恒定纬度的经向圆圈上的$f_l$个离散值,其周长为C,计算DFT $F_k$如下:
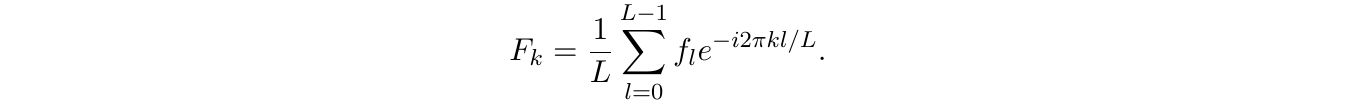
然后能量谱被设定为:
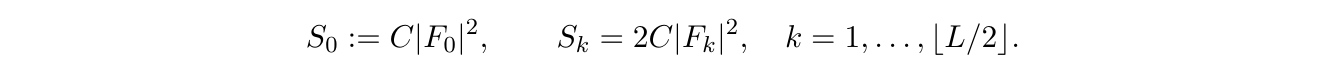
对于波数k > 0,因其同时考虑了负频率和正频率的内容,因此出现了因子2。
这种规范化的选择确保了能量的帕斯瓦尔关系成立:假设$f_l$是连续函数f(l)在0 < l < C (m)范围内的采样值,那么 (C/L) 是经向采样点的间隔,因此:
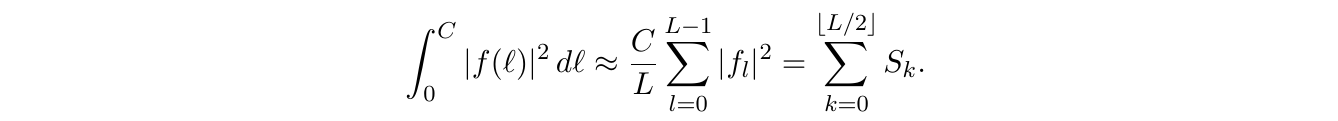
为了得到最终的谱,我们对30◦ < |lat| < 60◦之间的经向谱进行平均。
4.4.4 头条分数
头条分数列在表3中。它们反映了中期预报中最常评估的变量。上层变量被选择来捕捉大气层的大尺度演变。Z500和T850尤其是对副热带动力学的良好追踪器。Q700提供了湿气输送和间接地云的代理。地表变量与天气影响紧密相关,通过2米温度(T2M)、10米风速(WS10)和24小时降水累积(TP24hr)。平均海平面气压(MSLP)是更大尺度动力学的另一种测量方式,也是热带和副热带气旋强度的良好代理。
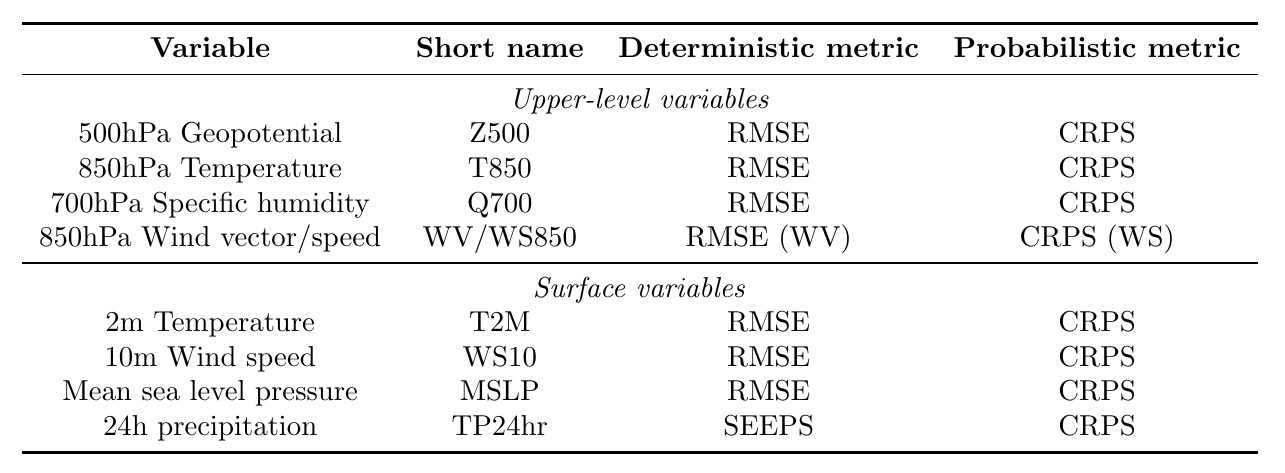 表3:头条分数列表。WV代表风速向量;WS代表风速。