了解强化学习 (RL) 的所有知识,以及如何使用 Unsloth 和 GRPO 训练你自己的 DeepSeek-R1 推理模型。从入门到高级的完整指南。
目录
你将学到什么?
- 什么是强化学习 (RL)?RLVR?PPO?GRPO?RLHF?RFT?“运气就是你所需要的一切?”这句话对强化学习适用吗?
- 什么是环境?代理?行动?奖励函数?奖励?
本文将涵盖关于 GRPO、强化学习 (RL) 和奖励函数你需要了解的一切(从初级到高级),以及使用 Unsloth 运行 GRPO 的技巧和基础知识。如果你正在寻找使用 GRPO 的分步教程,请参阅我们的指南。
❓什么是强化学习 (RL)?
强化学习的目标是:
- 增加看到“好”结果的几率。
- 减少看到“坏”结果的几率。
就是这样!关于“好”和“坏”的含义,或者我们如何“增加”或“减少”它们,甚至“结果”的含义,都存在着复杂性。
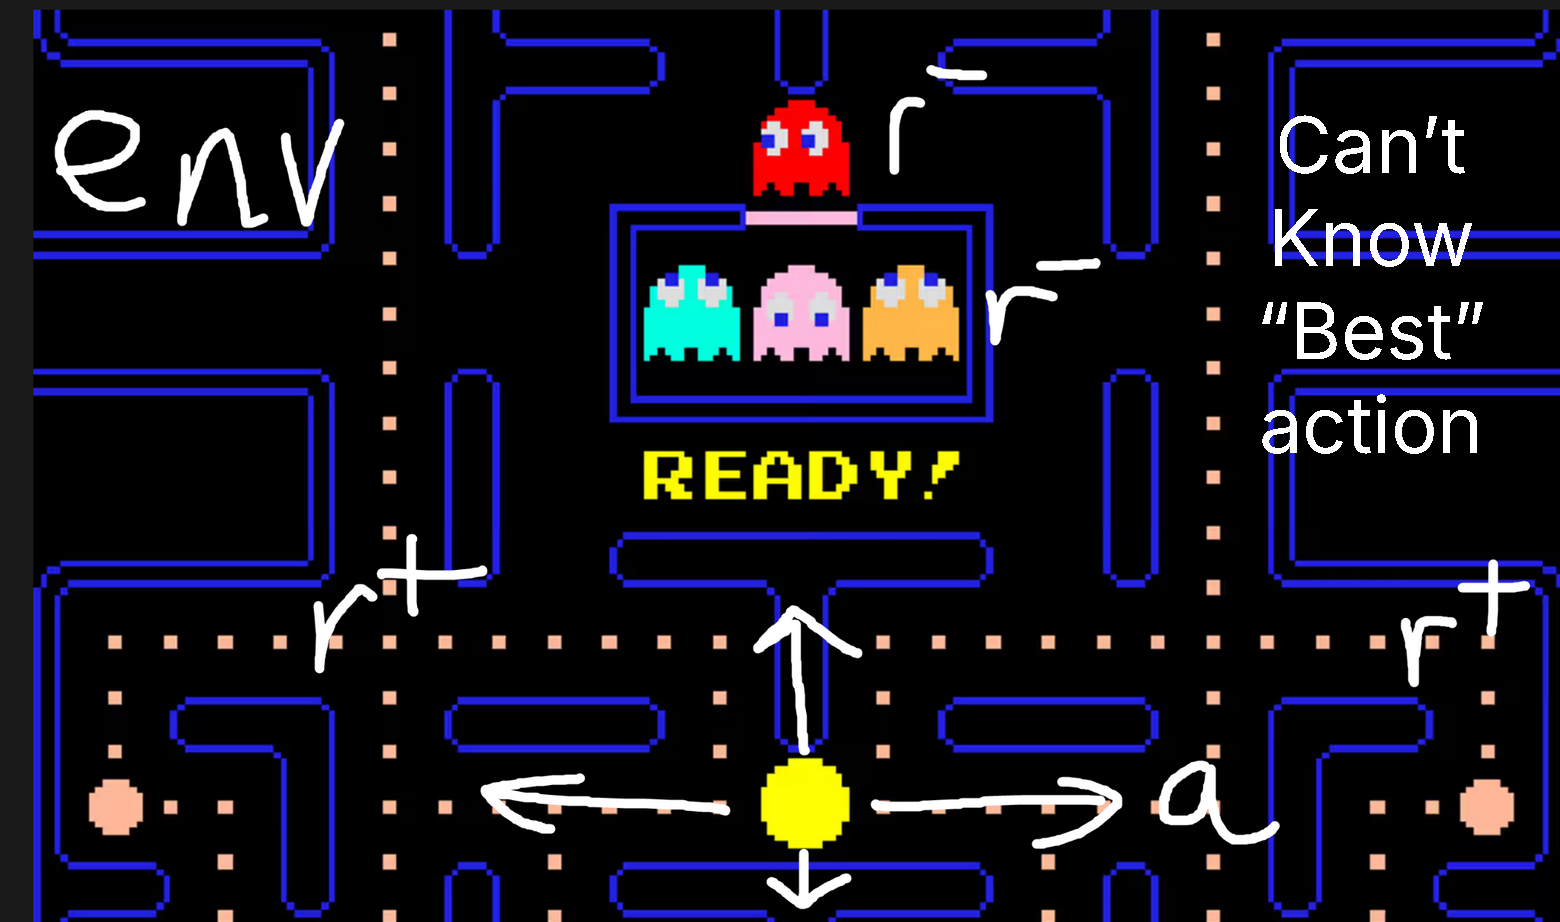
例如,在吃豆人游戏中:
- 环境就是游戏世界。
- 你可以采取的行动是上、左、右和下。
- 如果你吃了一个饼干,奖励是好的;如果你碰到一个弯弯曲曲的敌人,奖励是坏的。
在强化学习中,你无法知道你能采取的“最佳行动”,但你可以观察中间步骤,或者最终的游戏状态(赢或输)。
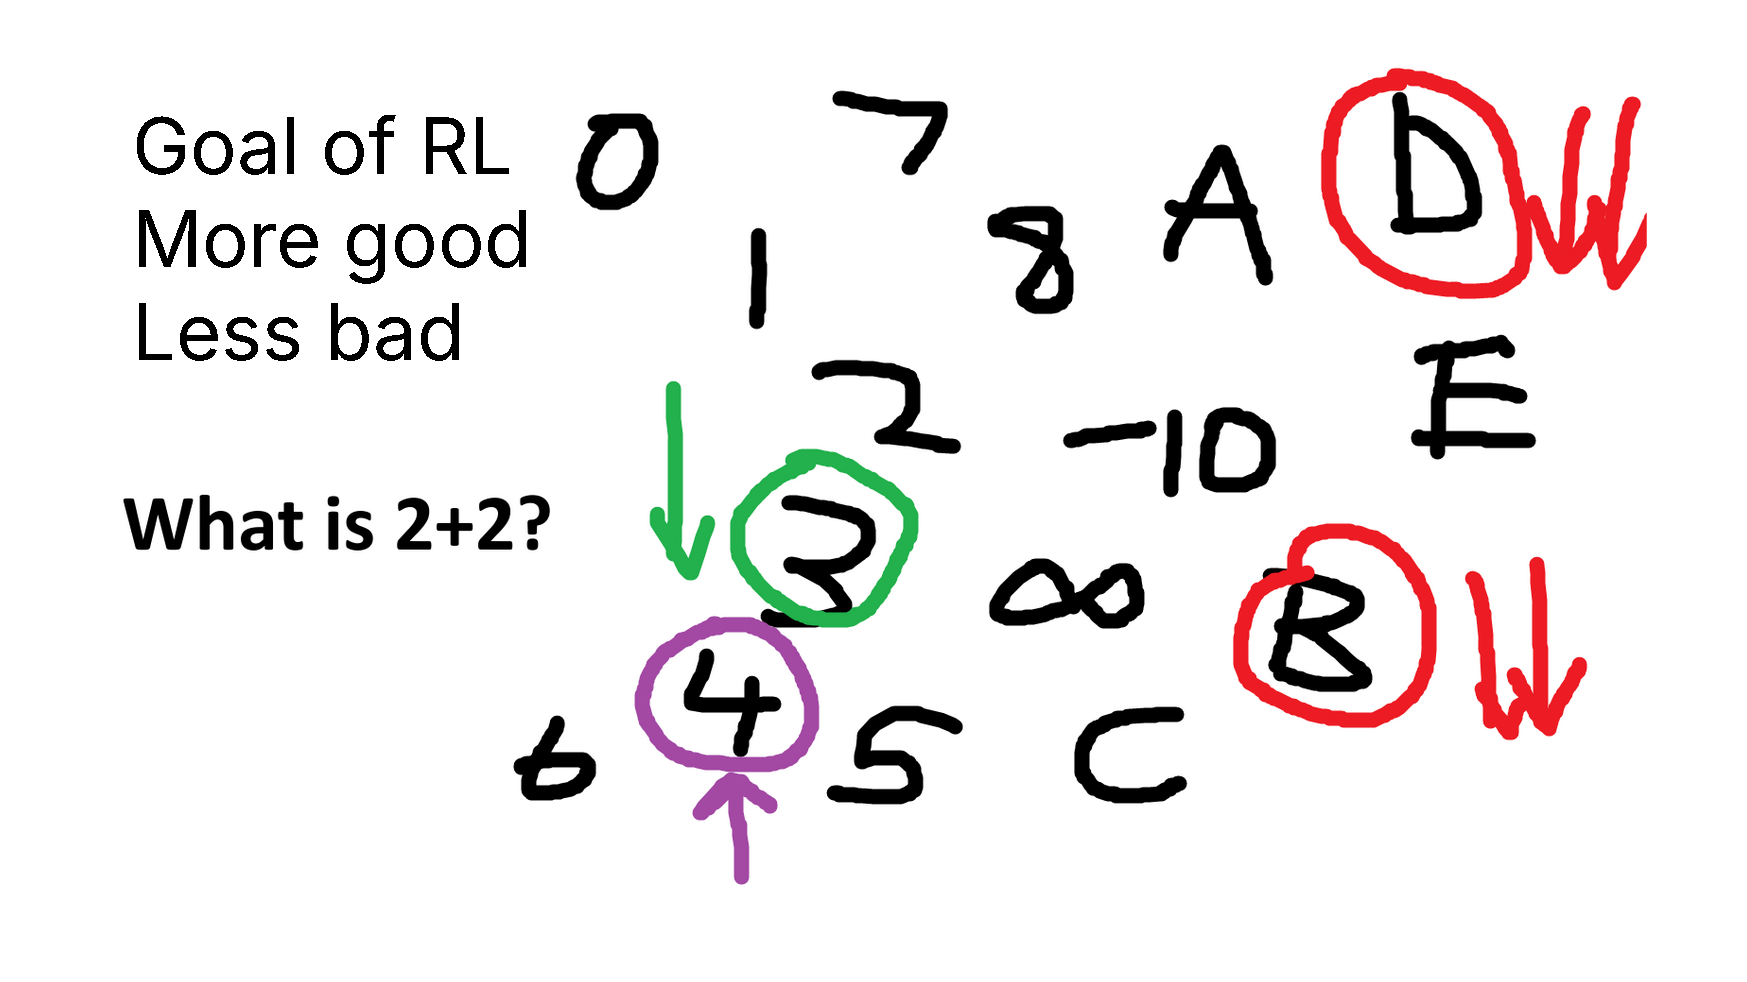
另一个例子是,想象你被问到这样一个问题:“2 + 2 等于多少?”(4)一个未经对齐的语言模型会吐出 3、4、C、D、-10,实际上是任何东西。
数字总比 C 或 D 好吧? 得到 3 总比得到 8 好吧? 得到 4 绝对是正确的。 我们刚刚设计了一个奖励函数!
从RLHF、PPO到GRPO和RLVR
OpenAI推广了RLHF(基于人类反馈的强化学习)的概念,即我们训练一个“智能体”来对问题(状态)生成输出,并由人类评估这些输出是否更有用。例如,ChatGPT中的点赞和点踩就可以用于RLHF过程。
PPO公式
PPO(近端策略优化)是为了进行RLHF而开发的。在这种情况下,智能体就是语言模型。实际上,它由三个系统组成:
- 生成策略(当前训练的模型)
- 参考策略(原始模型)
- 价值模型(平均奖励估计器)
我们使用奖励模型来计算当前环境的奖励,而我们的目标是最大化这个奖励!PPO的公式看起来相当复杂,因为它被设计成稳定的。其中的clip(..., 1-e, 1+e)项用于强制PPO不进行过大的改变。还有一个KL项,其中beta设置为>0,以强制模型不要偏离太多。关于PPO更深入的数学推导,请访问我们在2025年关于强化学习的AI工程师讲座。
GRPO和RLVR
DeepSeek开发了GRPO(组相对策略优化)来训练他们的R1推理模型。与PPO的主要区别在于:
- 价值模型被移除,取而代之的是多次调用奖励模型获得的统计数据。
- 奖励模型被移除,取而代之的是可以使用RLVR的自定义奖励函数。这意味着GRPO效率极高。以前PPO需要训练多个模型——现在移除了奖励模型和价值模型,我们可以节省内存并加速所有过程。
RLVR(可验证奖励强化学习)允许我们根据具有易于验证解决方案的任务来奖励模型。例如:
- 数学方程可以轻松验证。例如:2+2 = 4。
- 代码输出可以验证是否正确执行。
设计可验证的奖励函数可能很困难,因此大多数示例都是数学或代码。GRPO的用例不仅限于代码或数学——其推理过程可以增强电子邮件自动化、数据库检索、法律和医学等任务,根据您的数据集和奖励函数大大提高准确性——诀窍是定义一个评分标准,即一个由更小的、可验证的奖励组成的列表,而不是一个最终的、包罗万象的单一奖励。例如,OpenAI在其强化学习微调(RFT)服务中推广了这一点。