本文翻译panda-gym: Open-source goal-conditioned environments for robotic learning。
目录
摘要
本文介绍了 panda-gym,这是一套与 OpenAI Gym 集成的 Franka Emika Panda 机器人强化学习 (RL) 环境。其中包含五项任务:抓取、推动、滑动、拾取与放置以及堆叠。它们都遵循多目标 RL 框架,允许使用面向目标的 RL 算法。为了促进开放研究,我们选择了开源物理引擎 PyBullet。此软件包的实现允许非常容易地定义新任务或新机器人。本文还展示了使用最先进的无模型离策略算法获得的基线结果。panda-gym 是开源的,可从 https://github.com/qgallouedec/panda-gym 免费获取。
1 引言
最近应用于机器人技术的强化学习进展,使得学习复杂的机械臂操作任务成为可能。然而,当前的算法仍然难以解决奖励非常稀疏的任务。最近的算法促进了这一领域的发展,但学习一个令人满意的模型所需的交互次数仍然非常高。目前,学习具有稀疏奖励函数的复杂任务需要在仿真中进行。现有大量适用于各种应用的物理模拟器 [Collins et al., 2021]。对于机器人操作,Franka Emika 的 Panda 机械臂被广泛使用。因此,我们为该机械臂提供了一个模拟环境,用于评估 RL 算法的常见任务。与软件包名称所暗示的相反,可以轻松定义新的机器人,这些机器人可以直接与现有任务一起使用。
2 环境
所呈现的环境包含一个来自 Franka Emika¹ 的 Panda 机器人手臂,该手臂已广泛用于仿真和实际的许多学术工作中。它有 7 个自由度和一个平行夹爪。该机器人使用 PyBullet 物理引擎 [Coumans and Bai, 2016] 进行仿真,该引擎具有开源且显示出非常好的仿真性能的优点。
这些环境与 OpenAI Gym [Brockman et al., 2016] 集成,允许使用基于此 API 的所有学习算法。Plappert 等人 [2018] 和 Andrychowicz 等人 [2018] 提出的所有任务都在此软件包中具有等效实现。我们还添加了一个堆叠任务,这比其他任务更难解决,因为需要移动两个物体(而不是像拾取与放置任务那样只移动一个)。所提出的环境都遵循多目标 RL 框架 [Plappert et al., 2018]。在每个回合中,都会随机生成一个新目标。此目标的类型取决于任务。例如,对于抓取任务,随机生成的是夹爪需要到达的位置。因此,观察结果会增加两个额外的向量:期望目标 (desired goal) 和已达到目标 (achieved goal)。
2.1 任务
一项任务包括将夹爪或一个(或多个)物体移动到目标位置。当要移动的实体与目标位置之间的距离小于 5 厘米时,任务完成。这些任务的难度级别递增。每项任务的渲染图都显示在图 1 中。
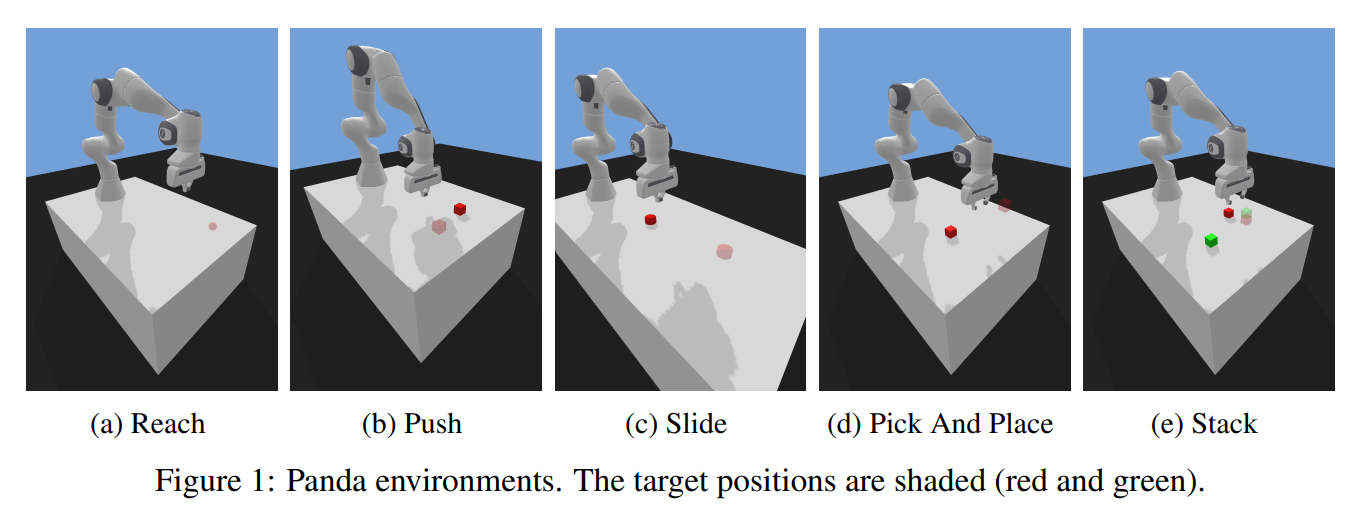
- PandaReach-v1:夹爪必须到达一个目标位置。此目标位置在 30 厘米 × 30 厘米 × 30 厘米的体积内随机生成。
- PandaPush-v1:一个放置在桌面上的立方体必须被推到一个也在桌面上的目标位置。夹爪被锁定闭合。目标位置和立方体的初始位置在机器人中立位置周围的 30 厘米 × 30 厘米正方形内随机生成。
- PandaSlide-v1:一个扁平圆柱体(例如冰球)必须被移动到桌面上的一个目标位置。夹爪被锁定闭合。目标位置在机器人中立位置前方,超出机器人可及范围的 50 厘米 × 50 厘米正方形内随机生成。因此,需要对物体施加一个冲量,而不仅仅是推动它。
- PandaPickAndPlace-v1:一个立方体必须被带到桌面上方 30 厘米 × 30 厘米 × 20 厘米体积内生成的目标位置。
- PandaStack-v1:两个立方体必须堆叠在桌面上的目标位置。目标位置在 30 厘米 × 30 厘米的正方形内生成。堆叠必须按正确的顺序完成:红色立方体必须在绿色立方体的下方。
2.2 观察空间和动作空间
观察空间因任务而异。对于所有任务,观察都包含夹爪的位置和速度(6个坐标)。夹爪的控制不允许改变其方向。因此,其状态完全由这 6 个坐标决定。如果任务涉及一个或多个物体,观察空间包含每个物体的位置、方向、线速度和角速度(12个坐标)。当夹爪未被强制关闭时,夹爪的张开度(即手指之间的距离)是观察空间的一部分(1个坐标)。
动作空间由夹爪移动指令(3个坐标,每个运动轴 x, y 和 z 各一个)和手指移动(1个坐标,对应于夹爪张开度的变化)组成。对于某些任务,夹爪被锁定闭合。对于这些任务,动作空间仅由夹爪运动指令组成。
在智能体的每个动作中,模拟器运行 20 个时间步,然后将控制权交还给智能体,等待下一个动作。另一方面,一个模拟器时间步代表 2 毫秒。因此,交互频率为 25 赫兹。一个回合由 50 次交互组成,因此一个回合的持续时间为 2 秒(对于堆叠任务,一个回合持续 100 次交互,因此为 4 秒)。这些持续时间在经验上足以完成相应的任务。
2.3 奖励
默认情况下,奖励是稀疏的:如果待移动实体位于所需位置(容差为 5 厘米),则获得 0 奖励;否则获得 -1 奖励。对于每个环境,都存在一个变体,其中奖励是密集的:此奖励是待移动实体与所需位置之间距离的相反数²。
通常,稀疏奖励函数更容易定义,因为它只涉及评估任务是否在当前状态下完成。相反,定义密集奖励函数可能是一个棘手的过程,特别是当任务包含多个完成标准时。例如,对于一个包含移动和旋转立方体的任务(未来版本软件包中考虑的任务,参见第 5 节),定义一个密集奖励函数需要为每个标准分配偏好权重 [Gábor et al., 1998, Natarajan and Tadepalli, 2005]。这些偏好构成了额外的超参数。
3 设计决策
一个机器人环境由一个机器人手臂和一个任务组成。从概念上讲,一个机器人手臂可以执行不同的任务。同样,一个任务也可以由不同的机器人执行。为了实现这种灵活性,我们将任务类与机器人类分离。这使得可以轻松定义新任务而无需担心执行它的机器人。同样,也可以定义新机器人而无需担心要执行的任务。图 2 显示了所选择的实现方式。
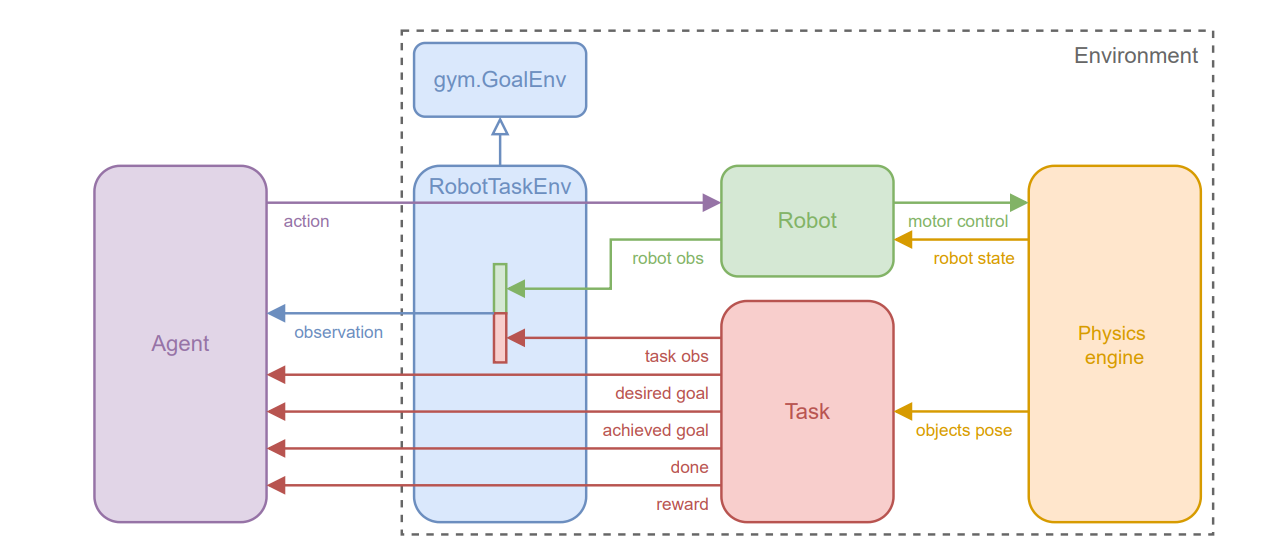 图 2:代码设计。任务和机器人是分离的,这使得它们具有模块化。代理的动作被发送到机器人。
主类名为 RobotTaskEnv,它包含一个 robot 属性和一个 task 属性。当代理采取行动,向环境发送一个动作时,环境将其传输给机器人。收集到的观察是机器人特有的观察(例如,夹爪的姿态)和任务特有的观察(例如,物体的姿态)的拼接。最后,为了遵循多目标框架,期望目标和已达成目标都从 task 属性派生。
所提出的环境允许快速学习,即使在计算能力有限的计算机上也能实现。PyBullet 物理引擎允许并行模拟多个场景。因此,这些环境与使用多个 CPU 核心的学习方法兼容。测试表明,这些环境平均比在 MuJoCo³ 上开发的同类环境快 9.2%。
4 实验结果
轨迹的长度是 50 个时间步,除了堆叠任务,由于其复杂性更高,我们选择了 100 个时间步的长度。在每个轨迹结束时,环境会重置并随机生成一个新目标。学习过程分布在 8 个 CPU 核上。每个核生成轨迹,所有这些轨迹都存储在一个公共回放缓冲区中。结果是定期在学习过程中对 80 个测试回合评估的成功率。我们给出了使用事后经验回放(HER) [Andrychowicz et al., 2018] 的最新文献中的三种离策略算法获得的基线结果:深度确定性策略梯度(DDPG) [Lillicrap et al., 2015]、软演员-评论家(SAC) [Haarnoja et al., 2018] 和双重延迟 DDPG(TD3) [Fujimoto et al., 2018]。用于训练的 DDPG 实现是 Dhariwal 等人 [2017] 提出的。已经对 DDPG 进行了适当修改以实现 TD3 和 SAC⁴。超参数在附录 A 中提供。学习曲线如图 3 所示。请注意,水平轴对应于与环境交互的总次数。因此,学习曲线独立于用于收集这些交互的工作器数量。
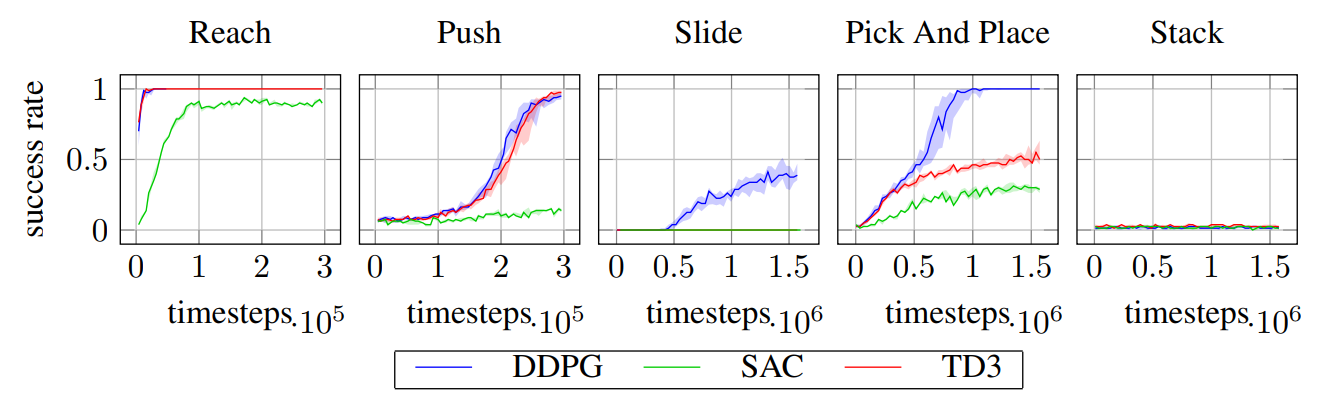 图 3:五种 Panda 环境的成功率。我们对每个实验重复 21 个不同的随机种子。中位数是实线,四分位距是阴影区域。我们展示了 DDPG、SAC 和 TD3 算法的结果,所有这三种算法都与 HER 一起运行。水平轴对应于与环境交互的总次数。
解决任务所需的时间步数取决于任务和算法。对于 DDPG,抓取和推动任务的成功率分别在 10⁴ 和 3 × 10⁴ 时间步后达到 100%。滑动和拾取与放置任务的成功率分别在 6 × 10⁵ 和 1.6 × 10⁶ 时间步后达到约 50%。堆叠任务的成功率在训练 1.6 × 10⁶ 时间步后仍接近 0。所呈现的算法无法在如此多的时间步内解决该任务。
我们注意到,对于 TD3 和 SAC,裁剪双 Q 技巧的消融实验允许在多个环境中显著提高结果。表示不同消融实验结果的曲线集在附录 B 中给出。附录 D 展示了在训练结束时已解决或部分解决的四个任务的策略概述。
5 结论和未来工作
在本文中,我们描述了 panda-gym,一个免费开源的软件包,它允许定义机器人任务,其中 5 个任务存在于当前版本中。它们允许在复杂机器人任务的背景下评估强化学习算法。架构选择允许非常容易地定义新任务和新机器人。最后,最先进的算法允许解决一些任务,而其他任务仍然未解决。
我们计划在现有任务中添加一些新的、非常常用的任务,例如孔洞插入(peg-in-hole insertion) [Lee et al., 2019] 或立方体翻转(cube flipping) [OpenAI, 2020]。另一方面,我们还计划提供直接用关节值控制机器人的可能性。这将要求智能体自行学习逆机器人动力学。最后,为了更好地符合现实,我们计划添加使用包含多种模态的观察空间的可能性,例如 RGB 摄像头、深度摄像头、力传感器或触觉传感器。