本文翻译On the Use and Misuse of Absorbing States in Multi-agent Reinforcement Learning。
目录
摘要
在合作式多智能体强化学习 (MARL) 中,智能体的创建和销毁是一个被严重忽视的研究领域。当前的 MARL 算法通常假设群体中智能体的数量在整个实验过程中保持固定。然而,在许多实际问题中,智能体可能会在其队友之前终止。这种早期终止问题带来了挑战:终止的智能体必须从其自身存在之外的群体成功或失败中学习。我们将这种将剩余队友获得的奖励价值传播给已终止智能体的问题称为身后归因问题 (Posthumous Credit Assignment)。
当前的 MARL 方法通过将这些智能体置于吸收状态来处理此问题,直到整个智能体组达到终止条件。尽管吸收状态使现有算法和 API 能够在不修改的情况下处理已终止的智能体,但仍存在实际的训练效率和资源使用问题。
在这项工作中,我们首先证明了在全连接网络的玩具监督学习任务中,样本复杂度随着吸收状态数量的增加而增加,而注意力机制对可变大小的输入更具鲁棒性。然后,我们为现有的最先进 MARL 算法提出了一种新颖的架构,该架构使用注意力机制而不是带有吸收状态的全连接层。最后,我们证明了这种新颖的架构在智能体在情节内被创建或销毁的任务以及标准的多智能体协调任务中,都显著优于标准架构。
1 引言
在许多现实场景中,智能体必须相互协作以实现共同目标。在这些环境中,单智能体强化学习 (RL) 方法可能会因多种原因而失败或表现不佳,例如多智能体系统固有的部分可观测性,而智能体数量的增加会加剧这一问题。多智能体强化学习 (MARL) 有望通过去中心化执行和中心化训练(Lowe 等人 2017)的范式来解决这些问题。在这种范式中,智能体利用局部观测进行行动,但在训练期间会使用所有全局可用的信息。
MARL 文献(Lowe 等人 2017;Foerster 等人 2018;Long 等人 2020;Iqbal 等人 2021)通常假设我们训练的智能体数量是固定的。然而,这不适用于许多 MARL 的实际应用。例如,团队视频游戏中的智能体可能在一个回合内“生成”(即被创建)或“死亡”(即在其他智能体之前终止)。类似地,团队协作的机器人可能会电量耗尽,需要在队友之前终止其轨迹。通常,智能体可能会提前终止,这意味着它在回合中不再影响环境或其他智能体。此外,也可能在回合中加入额外的智能体。
通常,现有算法通过将非活跃智能体置于吸收状态来处理这些情况。无论行动选择如何,智能体都会保持在吸收状态,直到整个智能体组达到终止条件。吸收状态使现有算法能够在不进行任何架构更改的情况下训练合作智能体来解决具有早期终止的任务,并简化了环境和多智能体 API 的实现。此外,吸收状态使得去中心化 POMDPs (Oliehoek 和 Amato 2016) 和马尔可夫博弈 (Littman 1994) 能够在不修改的情况下表示具有早期终止的任务。
然而,吸收状态在训练效率和资源利用方面引入了实际问题。具体来说,当使用神经网络作为函数近似器时,吸收状态在输入分布中引入了一些元素,这些元素由于其构造的必然性使得目标函数更难以近似。此外,吸收状态对于大量智能体来说不是一个可扩展的解决方案。根据问题,非少量资源可能会被用于那些不影响环境的智能体。在极端情况下,如果一个群体有超过 50% 的损耗,那么用于非影响智能体的通信和存储会消耗更多资源。当存在严格的资源限制时,这些未充分利用的资源尤其令人担忧。
智能体早期终止带来的关键挑战是信用分配——我们称之为身后归因 (Posthumous Credit Assignment)。从环境中移除的智能体将不会体验到终止后给予群体的任何奖励。因此,它们将无法学习其终止前的行动是否对群体有价值。吸收状态通过在状态空间中创建一个路径来解决这个问题,通过该路径可以从智能体早期终止之后传播价值。
在这项工作中,我们提出了一种新颖的架构,该架构使用注意力机制而不是带有吸收状态的全连接层来改进最先进的 MARL 算法反事实多智能体策略梯度 (COMA)(Foerster 等人 2018)。我们将我们提出的架构称为多智能体身后归因 (MA-POCA)。MA-POCA 自然地处理在回合内创建或销毁但共享奖励函数的智能体。在中心化训练、去中心化执行框架内工作,我们只需要使评论者能够处理每个时间步变化的智能体数量。通过在评论者之前仅对活跃智能体信息应用自注意力机制(Vaswani 等人 2017),MA-POCA 可以扩展到任意数量的智能体。此外,注意力机制允许评论者将群体未来的预期价值归因于具有已终止智能体的状态,而无需吸收状态。最后,注意力机制使得对于具有连续和离散动作空间的智能体,可以实现反事实基线(Foerster 等人 2018)。
这项工作有三个主要贡献。
- 我们证明了在全连接网络的玩具监督学习任务中,样本复杂度随着吸收状态数量的增加而增加,而注意力机制对可变大小输入更具鲁棒性。
- 我们提出了一种新颖的架构 MA-POCA,它无需使用吸收状态即可将剩余队友获得的奖励传播给已终止智能体。此外,由于它不依赖于固定数量的智能体,MA-POCA 也支持在回合期间创建新智能体。
- 我们对两个标准的多智能体协调任务以及两个智能体可以生成或死亡的新任务进行了实验。我们表明 MA-POCA 在前者的任务中提供了改进,并在后者的任务中显著优于基线。
2 预备知识
MARL 符号
我们考虑的设置是一个去中心化部分可观测马尔可夫决策过程 (decentralized-POMDP) (Oliehoek and Amato 2016),其定义如下:($N, S, O, A, P, r, γ$) 其中 $N \ge 1$ 是智能体数量,$S$ 是环境的状态空间。$O$ 是所有智能体的联合观测空间 $O := O_1 \times … \times O_N$,其中 $O_i$ 是智能体 $i$ 的观测空间。在时间 $t$,环境处于状态 $s_t \in S$,而 $o^i_t \in O_i$ 是智能体 $i$ 的局部观测,它与 $s_t$ 相关。环境状态可能包含任何智能体局部不可用的信息,例如当前正在行动的智能体总数。$A$ 是所有智能体的联合动作空间 $A := A_1 \times … \times A_N$,其中 $A_i$ 是智能体 $i$ 的动作空间。请注意,不同智能体的观测空间和动作空间不必相等。此外,我们使用粗体向量来表示智能体上的联合量,例如联合动作 $\mathbf{a} = (a_1, …, a_N)$ 或联合观测 $\mathbf{o} = (o_1, …, o_N)$,其中 $\mathbf{a} \in A$ 且 $\mathbf{o} \in O$。
$P : S \times A \times S \to [0, 1]$ 是转移函数,其中 $P(s’|s, \mathbf{a})$ 是给定当前状态 $s$ 和联合动作 $\mathbf{a} \in A$ 时环境转移到状态 $s’$ 的概率。$r : S \times A \to \mathbb{R}$ 是共享奖励函数,其中 $r(s, \mathbf{a})$ 是当采取联合动作 $\mathbf{a} \in A$ 且环境处于状态 $s \in S$ 时所有智能体获得的奖励。
中心化训练、去中心化执行
在这项工作中,我们考虑独立执行者与中心化评论者 (IACC) 学习框架 (Lyu et al. 2021),其中训练于联合信息的评论者用于更新一组独立执行者,采用执行者-评论者架构 (Konda and Tsitsiklis 2000)。独立执行者-评论者 (IAC) 方法为每个智能体独立训练一个评论者和策略,仅使用局部信息;而联合执行者-评论者 (JAC) 方法训练一个单一的联合策略和一个联合评论者。它们是竞争方法。通常,IAC 在需要显著协作的任务中表现不佳,因为它仅使用局部观测存在部分可观测性。此外,JAC 在实际场景中不实用,因为联合策略需要同时访问所有智能体观测才能生成动作,这实质上假设智能体和策略节点之间存在完美通信。
设 $\pi_i, 1 \le i \le N$ 表示每个独立执行者的策略。给定环境状态 $s_t$ 以及相应的联合观测 $\mathbf{o}_t$ 和动作 $\mathbf{a}_t$,联合策略 $\pi(\mathbf{a}_t|\mathbf{o}_t)$ 可以分解为 $\pi(\mathbf{a}_t|\mathbf{o}_t) = \prod_i \pi_i(a^i_t|o^i_t)$,因为智能体在局部观测上独立行动。
状态 $s_t$ 的中心化状态价值函数定义为:
\[V^{\pi} (s_t) = \mathbb{E}_{\pi} \left[ \sum_{l=0}^{\infty} \gamma^l r(s_{t+l}, \mathbf{a}_{t+l}) \right] \quad (1)\]中心化状态-动作价值函数定义为:
\[Q^{\pi} (s_t, \mathbf{a}_t) = r(s_t, \mathbf{a}_t) + \mathbb{E}_{\pi} \left[ \sum_{l=1}^{\infty} \gamma^l r(s_{t+l}, \mathbf{a}_{t+l}) \right] \quad (2)\]反事实基线
反事实基线利用差分奖励 (Wolpert and Tumer 2002),并引入了每个智能体的基线,使得优势函数能够反映个体智能体对总奖励的贡献 (Foerster et al. 2018)。形式上,通过将个体智能体的动作边缘化后的状态动作价值函数来计算基线:
\[b_i(s, \mathbf{a}) = \mathbb{E}_{a' \sim \pi_i(\cdot|o^i)}[Q^{\pi} (s, (\mathbf{a}^{-i}, a'))] \quad (3)\]其中 $\mathbf{a}^{-i}$ 是不包含第 $i$ 个条目的联合动作。那么,智能体 $i$ 的优势是:
\[Adv_i = Q^{\pi} (s, \mathbf{a}) - b_i(s, \mathbf{a}) \quad (4)\]智能体 $i$ 的更新是:
\[\nabla_{\theta_i} J(\theta_i) = \mathbb{E}_{s \sim \rho^{\pi}, a_i \sim \pi_i} \left[ \nabla_{\theta_i} \log \pi_i(a_i|o_i)(Q^{\pi} (s, \mathbf{a}) - b_i(s, \mathbf{a})) \right] \quad (5)\]使用此作为优势函数为每个智能体提供了塑形奖励,解决了确定个体智能体对群体共享奖励贡献多少的挑战。此外,通过使用反事实基线,梯度下降仍然收敛到局部最优策略 (Foerster et al. 2018)。
3 早期终止智能体的挑战
在本节中,我们引入身后归因问题 (Posthumous Credit Assignment problem),并讨论它如何适应去中心化 POMDP 框架。据作者所知,这是文献中首次明确提及身后归因问题。然后,我们将讨论如何通过使用吸收状态 (absorbing state) 来扩展去中心化 POMDP 框架以处理智能体销毁。吸收状态在 MARL 文献中有所提及 (Samvelyan et al. 2019; Yu et al. 2021),但我们提供了文献中缺乏的明确讨论。最后,我们讨论吸收状态引入的实际和理论问题。
身后归因问题
在共享奖励的合作环境中,智能体的行动旨在最大化群体的预期未来奖励。存在这样一些场景:某个智能体当前的行动使得群体能够在稍后的时间步获得奖励,但却导致该智能体自身立即终止(例如,一次自我牺牲事件)。从强化学习智能体的角度来看,它已被从环境中移除,因此将不再收到其群体可能稍后获得的奖励。此外,该智能体无法在群体收到奖励时观察环境状态。因此,智能体必须学习如何最大化它无法体验的奖励,这提出了一个关键的信用分配问题。我们称之为身后归因问题。
吸收状态
去中心化 POMDP 框架配备了通过吸收状态来建模具有身后归因问题的任务。对于每个智能体,令 $o^i_{abs} \in O_i$ 是一个独特的吸收状态,智能体 $i$ 在达到终止状态且不再在环境中活跃后将占据该状态。请注意,此吸收状态需要是每个智能体独有的,因为具有不同观测空间的智能体将进入不同维度的吸收状态。一旦智能体 $i$ 进入 $o^i_{abs}$,它将一直停留在那里,无论其行动如何,直到群体达到终止条件并且所有智能体都重置到新的初始状态。因此,对于 $o^i_{abs}$,以下条件成立:
\[p(o^i_{abs} | o^i_{abs}, a^i) = 1, \forall a^i \in A_i\]此外,当智能体 $i$ 处于状态 $o^i_{abs}$ 时,转移函数将独立于该智能体的行动。形式上,
\[P (s'|s, \mathbf{a}) = P (s'|s, \mathbf{a}^{-i})\]其中 $\mathbf{a}^{-i}$ 是不包含第 $i$ 个条目的联合动作。因此,引入吸收状态将原始问题转化为一个没有身后归因问题的标准去中心化 POMDP。
然而,尽管用去中心化 POMDP 形式和吸收状态来表示死亡和生成智能体的设置是直接的,但在实际使用吸收状态时会出现问题。我们认为通常最好避免使用吸收状态。两个主要关注点是:
- 吸收状态表示使基于神经网络的函数近似器的学习动态复杂化;
- 为不再影响环境的智能体引入的复杂性以及消耗的计算资源浪费。
吸收状态表示
吸收状态表示并非微不足道,因为在大多数算法中,函数近似器(如神经网络)将摄入这些状态表示。因此,状态的实际值和结构很重要,因为它们充当输入特征。此外,吸收状态必须与活跃智能体可访问的观测空间不相交。否则,我们将引入(额外的)部分可观测性,因为相同的值可能表示活跃或非活跃智能体。
作为案例研究,我们在图 1 中提供了一个玩具数值示例,以说明与注意力网络相比,带有吸收状态的全连接层不是一种样本高效的输入表示。我们训练一个神经网络来估计可变数量(最多 10 个)的均匀采样的浮点数的均值,范围在 [0.25, 0.75] 之间。我们比较了两种配置(所有超参数都包含在附录 D 中):
- 剩余值用固定的吸收状态 $o_{abs}$ 替换,样本被打乱以模拟强化学习场景中智能体提前终止。我们训练一个具有 2 个隐藏层、每层 32 个单元的全连接网络,使用 ReLU 激活函数;
- 自注意力 (Vaswani et al. 2017) 层处理可变输入。我们使用一个大小为 32 的单层实体嵌入,一个残差自注意力 (RSA) 块,然后通过线性变换到输出空间。RSA 块的实现细节包含在附录 B 中。
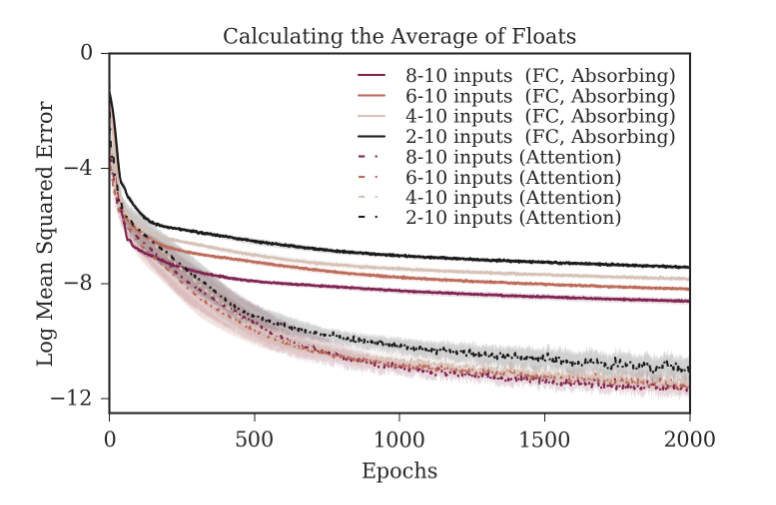 图 1:计算可变数量浮点数平均值的学习样本效率,取决于吸收状态的数量以及网络输入的表示方式。在性能和对更大输入变化的鲁棒性方面,注意力机制优于吸收状态。曲线表示 20 个随机种子下的均值和 95% 置信区间。
在图 1 中,我们提供了使用带有吸收状态的全连接层和注意力机制来学习计算 2 到 10 个、4 到 10 个、6 到 10 个和 8 到 10 个浮点数均值的损失曲线。对于每个数据点,输入的数量从范围内的均匀随机分布中抽取。在本实验中,吸收状态的值为 $o_{abs} = 0.0$,但其他选择的趋势相似。请注意,我们不能选择 $o_{abs} \in [0.25, 0.75]$,因为网络将无法学习何时应该或不应该将某个值包含在均值中。在附录 A 中,我们提供了 $o_{abs} = -1.0, 1.0, 0.4$ 的其他值的附加图,显示 -1.0 和 1.0 是合理的选择,但 0.4 不行,因为它包含在 [0.25, 0.75] 中。此外,我们还提供了一个实验,其中每个样本的吸收状态数量是固定的,以证明改变浮点数数量更具挑战性。
当使用吸收状态时,我们观察到样本复杂度随吸收状态数量的增加而增加。具有更大最大吸收状态数量的运行需要更长时间才能收敛。我们还观察到注意力机制在该任务中显著优于吸收状态。当将此结果外推到强化学习设置时,由中心化价值函数学习的映射比这个简单的数值示例复杂得多,这可能会放大所讨论的问题。此外,在此示例中,吸收状态的存在只有一个确切的含义,即不将此输入包含在均值计算中。然而,在 MARL 设置中,群体结果可能是积极的、消极的或中性的,这取决于智能体的早期终止。那么,结果的变化对应于单个吸收状态 $o_{abs}$ 的高方差回报目标。一个可能的替代方法是使用多个吸收状态,每个结果对应一个。然而,可能无法知道哪个结果会跟随给定的早期终止,或者结果可能处于连续谱上。
实现复杂性和资源限制
从实践角度来看,吸收状态既需要额外的实现复杂性,又会增加资源开销。这些问题主要出现在两个方面:表示中心化价值函数的函数近似器的大小,以及冗余吸收状态的通信和存储。
为了使用吸收状态,我们必须调整中心化价值函数近似器的大小,使其能够将环境中可能活跃的绝对最大数量智能体的所有观测作为输入,无论在任何给定时间有多少智能体活跃。如果函数近似器是全连接神经网络,它必须为所有可能的智能体设置输入。除了增加学习过程的样本复杂度外,这些额外的参数在训练过程中还会带来不必要的计算开销。此外,在最大智能体数量未知的情况下(例如,当智能体的行动可以生成额外智能体时),我们必须为最大智能体数量选择一个任意大的值,从而加剧函数近似器的样本复杂性和计算开销问题。
我们还必须考虑吸收状态本身的计算和资源开销。大多数吸收状态的实现(例如 SMAC (Samvelyan et al. 2019))将其作为环境返回的状态的一部分添加。这优点在于算法实现不需要明确了解吸收状态。然而,由于这些吸收状态与其他任何状态的处理方式相同,它们也必须以与其他状态相同的方式进行处理、存储和通信。在依赖分布式推理工作器 (Espeholt et al. 2018; Horgan et al. 2018) 的分布式强化学习架构中,这些状态需要作为轨迹的一部分从这些工作器发送到优化器,这将引入通信开销。此外,它们将存在于任何缓冲区、队列中,并且对于离策略算法而言,还将存在于回放存储中,占用不必要的内存。通过将吸收状态的实现从环境移到算法中(例如,在将状态作为输入提供给中心化价值函数之前直接填充状态),这些问题可以部分缓解,但这会使算法的实现更复杂,并且在不同环境中的通用性降低。
3 早期终止智能体的挑战
在本节中,我们将介绍身后归因问题 (Posthumous Credit Assignment problem),并探讨它如何融入去中心化 POMDP (Partially Observable Markov Decision Process) 框架。据作者所知,这是文献中首次明确提及身后归因问题。随后,我们将讨论如何通过使用吸收状态 (absorbing state) 来扩展去中心化 POMDP 框架,以处理智能体的销毁。吸收状态在多智能体强化学习 (MARL) 文献中有所提及 (Samvelyan et al. 2019; Yu et al. 2021),但我们在此提供了文献中缺乏的明确讨论。最后,我们将探讨吸收状态所带来的实际和理论问题。
身后归因问题
在共享奖励的协作环境中,智能体的行动旨在最大化群体的预期未来奖励。然而,有些场景下,某个智能体的当前行动虽然能使群体在稍后的时间步获得奖励,却会导致该智能体自身的立即终止(例如,一次自我牺牲行为)。从强化学习智能体的角度来看,它已被从环境中移除,因此将不再收到其群体可能稍后获得的奖励。此外,该智能体也无法在群体收到奖励时观察环境的状态。因此,智能体必须学习如何最大化它无法亲身经历的奖励,这提出了一个关键的信用分配问题。我们称之为身后归因问题。
吸收状态
去中心化 POMDP 框架通过吸收状态来建模具有身后归因问题的任务。对于每个智能体,我们定义 $o^i_{abs} \in O_i$ 为一个独特的吸收状态。当智能体 $i$ 达到终止状态并在环境中不再活跃后,它将占据这个吸收状态。值得注意的是,这种吸收状态需要针对每个智能体单独定义,因为具有不同观测空间的智能体将进入不同维度的吸收状态。一旦智能体 $i$ 进入 $o^i_{abs}$,它将一直停留在那里,无论其采取何种行动,直到整个智能体群体达到终止条件,所有智能体都重置到一个新的初始状态。因此,对于 $o^i_{abs}$,以下条件始终成立:
\[p(o^i_{abs} | o^i_{abs}, a^i) = 1, \forall a^i \in A_i.\]此外,当智能体 $i$ 处于状态 $o^i_{abs}$ 时,转移函数将独立于该智能体的行动。形式上:
\[P (s'|s, \mathbf{a}) = P (s'|s, \mathbf{a}^{-i})\]其中 $\mathbf{a}^{-i}$ 是不包含第 $i$ 个条目的联合动作。因此,引入吸收状态将原始问题转化为一个标准的去中心化 POMDP,从而解决了身后归因问题。
然而,尽管使用去中心化 POMDP 形式和吸收状态来表示智能体死亡和生成的情况是直接的,但在实际应用中,吸收状态会引发一些问题。我们认为通常最好避免使用吸收状态。主要有两大顾虑:
- 吸收状态的表示会使基于神经网络的函数近似器的学习动态复杂化;
- 对于不再影响环境的智能体,它会引入不必要的复杂性并浪费计算资源。
吸收状态表示
吸收状态的表示并非微不足道,因为在大多数算法中,函数近似器(例如神经网络)会摄取这些状态表示作为输入。因此,状态的实际值和结构至关重要,因为它们充当输入特征。此外,吸收状态必须与活跃智能体可访问的观测空间不相交。否则,我们就会引入(额外的)部分可观测性,因为相同的值可能同时表示活跃或非活跃智能体。
作为案例研究,我们在图 1 中提供了一个玩具数值示例,旨在说明与注意力网络相比,带有吸收状态的全连接层在样本效率上表现不佳。我们训练一个神经网络来估计在 [0.25, 0.75] 范围内均匀采样的可变数量(最多 10 个)浮点数的均值。我们比较了两种配置(所有超参数均包含在附录 D 中):
- 配置一: 剩余的值被一个固定的吸收状态 $o_{abs}$ 替换,并且样本被打乱,以模拟强化学习场景中智能体提前终止的情况。我们训练一个具有 2 个隐藏层、每层 32 个单元的全连接网络,并使用 ReLU 激活函数。
- 配置二: 一个自注意力 (Vaswani et al. 2017) 层处理可变输入。我们使用一个大小为 32 的单层实体嵌入,一个残差自注意力 (RSA) 块,然后通过线性变换将其映射到输出空间。RSA 块的实现细节包含在附录 B 中。
图 1 显示了使用带有吸收状态的全连接层和注意力机制来学习计算 2 到 10、4 到 10、6 到 10 和 8 到 10 个浮点数均值的损失曲线。对于每个数据点,输入的数量从其各自范围内的均匀随机分布中抽取。在本实验中,吸收状态的值设置为 $o_{abs} = 0.0$,但其他选择也呈现出相似的趋势。请注意,我们不能选择 $o_{abs} \in [0.25, 0.75]$,因为这样网络将无法学习何时应该或不应该将某个值包含在均值计算中。在附录 A 中,我们提供了 $o_{abs} = -1.0, 1.0, 0.4$ 不同值的附加图,表明 -1.0 和 1.0 是合理的选择,但 0.4 不行,因为它包含在 [0.25, 0.75] 范围内。此外,我们还进行了一项实验,其中每个样本的吸收状态数量是固定的,以证明改变浮点数数量更具挑战性。
使用吸收状态时,我们观察到样本复杂度随吸收状态数量的增加而增加。具有最大吸收状态数量的运行需要更长时间才能收敛。我们还观察到,注意力机制在该任务中显著优于吸收状态。将此结果外推到强化学习设置时,中心化价值函数学习到的映射比这个简单的数值示例复杂得多,这可能会放大上述问题。此外,在本示例中,吸收状态的存在只有一个明确的含义,即不将此输入包含在均值计算中。然而,在 MARL 设置中,群体结果可能是积极的、消极的或中性的,这取决于智能体的早期终止。那么,结果的变化对应于单个吸收状态 $o_{abs}$ 的高方差回报目标。一种可能的替代方案是使用多个吸收状态,每个结果对应一个。然而,可能无法知道哪个结果会跟随给定的早期终止,或者结果可能是一个连续谱。
实现复杂性和资源限制
从实践角度来看,吸收状态既需要额外的实现复杂性,又会增加资源开销。这些问题主要出现在两个方面:表示中心化价值函数的函数近似器的大小,以及冗余吸收状态的通信和存储。
为了使用吸收状态,我们必须调整中心化价值函数近似器的大小,使其能够将环境中可能活跃的绝对最大数量智能体的所有观测作为输入,无论在任何给定时间有多少智能体活跃。如果函数近似器是一个全连接神经网络,它必须为所有可能的智能体预留输入。除了增加学习过程的样本复杂度外,这些额外的参数在训练过程中还会带来不必要的计算开销。此外,在最大智能体数量未知的情况下(例如,当智能体的行动可以生成额外智能体时),我们必须为最大智能体数量选择一个任意大的值,这将加剧函数近似器的样本复杂度问题和计算开销问题。
我们还必须考虑吸收状态本身的计算和资源开销。大多数吸收状态的实现(例如 SMAC (Samvelyan et al. 2019))将其作为从环境返回的状态的一部分添加。这优点在于算法实现不需要明确了解吸收状态。然而,由于这些吸收状态与其他任何状态的处理方式相同,它们也必须以与其他状态相同的方式进行处理、存储和通信。在依赖分布式推理工作器 (Espeholt et al. 2018; Horgan et al. 2018) 的分布式强化学习架构中,这些状态需要作为轨迹的一部分从这些工作器发送到优化器,从而引入通信开销。此外,它们将存在于任何缓冲区、队列中,并且对于离策略算法而言,还会存在于回放存储中,占用不必要的内存。通过将吸收状态的实现从环境转移到算法内部(例如,在将状态作为输入提供给中心化价值函数之前直接填充状态),可以部分缓解这些问题,但这会使得算法的实现更复杂,并在不同环境中的通用性降低。
4 方法
本节中,我们提出了一种名为 MA-POCA 的新颖架构,用于改进 COMA 算法 (Foerster et al. 2018)。MA-POCA 在评论者网络中利用自注意力机制 (self-attention) (Vaswani et al. 2017) 处理活跃智能体信息,从而在不需要吸收状态的情况下解决了身后归因问题 (posthumous credit assignment)。此外,自注意力机制使得网络架构能够高效地计算同质和异质智能体群体的反事实基线。值得注意的是,尽管去中心化 POMDP 框架要求已知最大智能体数量 $N$,但 MA-POCA 的算法和网络架构并不需要这一先验信息。
MA-POCA 架构
MA-POCA 学习一个中心化价值函数来估计智能体群体的预期折扣回报,以及一个中心化的以智能体为中心的反事实基线,以 COMA 的方式实现信用分配。在利用自注意力的架构中,通常会使用实体编码器 (entity encoders) 将实体映射到嵌入空间,然后再通过注意力层 (Baker et al. 2020)。在我们的设置中,我们将不同的观测空间视为实体。例如,如果两个智能体 $i, j$ 共享相同的观测空间 $O_i = O_j$,则相应的观测将使用相同的编码器进行嵌入。然而,如果 $O_i \neq O_j$,我们则使用不同的编码器进行嵌入。此外,我们将观测和观测-动作对视为独立的实体;观测和动作被拼接后进行嵌入。
形式上,令 $g_i : O_i \to E$ 是观测 $o_i \in O_i$ 的编码网络,其中 $E$ 是嵌入空间。如前所述,如果 $O_i = O_j$,则 $g_i = g_j$。
MA-POCA 价值函数
本节我们将讨论如何为可能存在早期终止的智能体群体估计公式 1 中给出的预期折扣回报。回想一下,在我们的设置中,活跃智能体的数量取决于时间步 $t$。因此,令 $k_t$ 表示在时间步 $t$ 的活跃智能体数量,且 $1 \leq k_t \leq N$,其中 $N$ 是在任何给定时间可以存活的最大智能体数量。
在 MARL 文献中,中心化状态或状态-动作价值函数通常有两种基于状态的条件化方式:
- 存在一个包含全局信息(例如所有智能体的坐标)的独立向量,该信息对任何单个智能体都是不可观测的 (Foerster et al. 2018; Rashid et al. 2018);
- 使用智能体的联合观测 $o_t \in O$,因为这被认为是全局状态的合理近似 (Long et al. 2020; Lowe et al. 2017)。
也可以使用混合方式。在这项工作中,我们仅考虑活跃智能体的联合观测,尽管前者仍然需要在某种程度上使用吸收状态或值,并且可以通过类似于以下方式进行处理。
为了处理每个时间步可变数量的智能体,我们首先对所有活跃智能体的观测 $g_i(o^i_t)_{1 \le i \le k_t}$ 进行编码,然后将编码结果通过一个 RSA (Residual Self-Attention) 块。我们使用的 RSA 块在架构上类似于标准 Transformer 架构 (Vaswani et al. 2017) 中使用的那些,但没有位置编码 (Baker et al. 2020)。有关自注意力机制的更多详细信息,请参见附录 B。然后,由 $\phi$ 参数化的中心化状态价值函数具有以下形式:
\[V_{\phi}(\text{RSA}(g_i(o^i_t)_{1 \le i \le k_t})) \quad (6)\]并使用 TD($\lambda$) (Sutton 1988) 进行训练:
\[J(\phi) = (V_{\phi}(\text{RSA}(g_i(o^i_t)_{1 \le i \le k_t})) - y(\lambda))^2 \quad (7)\]其中:
\[y(\lambda) = (1 - \lambda) \sum_{n=1}^{\infty} \lambda^{n-1} G_t^{(n)}\] \[G_t^{(n)} = \sum_{l=1}^{n} \gamma^{l-1} r_{t+l} + \gamma^n V_{\phi}(\text{RSA}(g(o^i_{t+n})_{1 \le i \le k_{t+n}}))\]其中 $k_{t+n}$ 是在时间 $t+n$ 活跃的智能体数量。请注意,$k_{t+n}$ 可能大于或小于 $k_t$,因为在时间步 $t$ 任何数量的智能体都可能提前终止或被生成。通过这种方式,从时间 $t+n$ 开始的预期价值可以传播到在时间 $t$ 终止的智能体。
MA-POCA 反事实基线
试图最大化共享奖励函数的智能体面临信用分配问题,因为很难分离出某个智能体的动作对群体回报的贡献 (Foerster et al. 2018)。反事实基线(公式 3)通过在中心化状态-动作价值函数中边缘化单个智能体的动作,从而能够计算塑形后的、每个智能体的优势。尽管 COMA 原始实现中使用的架构具有许多优点,但它仅限于离散动作和固定数量智能体的问题。在这项工作中,我们提出了一种利用自注意力机制的替代方案,它缓解了这两个限制。
我们认为观测和观测-动作对是不同的实体。令 $f_i : O_i \times A_i \to E$ 为观测-动作对的编码网络,反事实基线可以通过使用蒙特卡洛样本估计公式 3 中的期望来显式学习 (Foerster et al. 2018)。因此,我们可以通过学习一个价值函数来学习某个智能体 $j$ 的反事实基线,该价值函数以所有智能体 $i$($1 \leq i \leq k_t, i \neq j$)的观测-动作对以及仅智能体 $j$ 的观测为条件。再次使用 RSA 块以及观测和观测-动作实体编码器,由 $\psi$ 参数化的智能体 $j$ 的基线形式为:
\[Q_{\psi}(\text{RSA}(g_j(o^j_t), f_i(o^i_t, a^i_t)_{1 \le i \le k_t, i \neq j}))\]基线的目标是:
\[J(\psi) = (Q_{\psi}(\text{RSA}(g_j(o^j_t), f_i(o^i_t, a^i_t)_{1 \le i \le k_t, i \neq j})) - y(\lambda))^2 \quad (8)\]它使用与公式 7 中价值函数更新相同的目标 $y(\lambda)$。
请注意,一个单一的联合观测 $\mathbf{o} = (o_1, …, o_N)$(和动作)会产生最多 $N$ 个不同的样本,用于更新公式 8,每个 $j$($1 \leq j \leq N$)对应一个样本。这是为价值函数和基线使用独立参数集的关键原因:在我们的训练机制中,基线通过所有智能体观测的排列进行训练,以估计每个智能体的基线,而价值函数则不然。这意味着用于计算基线的样本量可能会比价值函数多出 $N$ 倍。我们假设这会导致基线主导(baseline dominance),并且通过实验我们发现使用单独的网络表现更好。
最后,用于公式 5 更新的智能体 $j$ 的优势由以下公式给出:
\[Adv_j = y(\lambda) - Q_{\psi}(\text{RSA}(g_j(o^j_t), f_i(o^i_t, a^i_t)_{1 \le i \le k_t, i \neq j}))\]